El impacto ambiental de la IA generativa: ¿cómo puede ayudar a ganar eficiencia reducirlo?
Citar
@misc{mortas2026impacto,
  author = {MORTAS, Félix},
  title = {El impacto ambiental de la IA generativa: ¿cómo puede ayudar a ganar eficiencia reducirlo?},
  year = {2026},
  url = {https://felixmortas.com/ai-env-impact-knowledge/es/},
  note = {Consultado en línea; última modificación: 15 de octubre de 2026}
}Se oye a menudo que una consulta a ChatGPT consume seis veces más electricidad que una búsqueda en Google, y que hace falta aproximadamente medio litro de agua para generar entre 10 y 50 respuestas [1].
¿Pero reflejan realmente estas cifras la realidad?
¡No tan rápido! Detrás de estas afirmaciones se esconden aproximaciones y atajos metodológicos que merecen examinarse más de cerca.
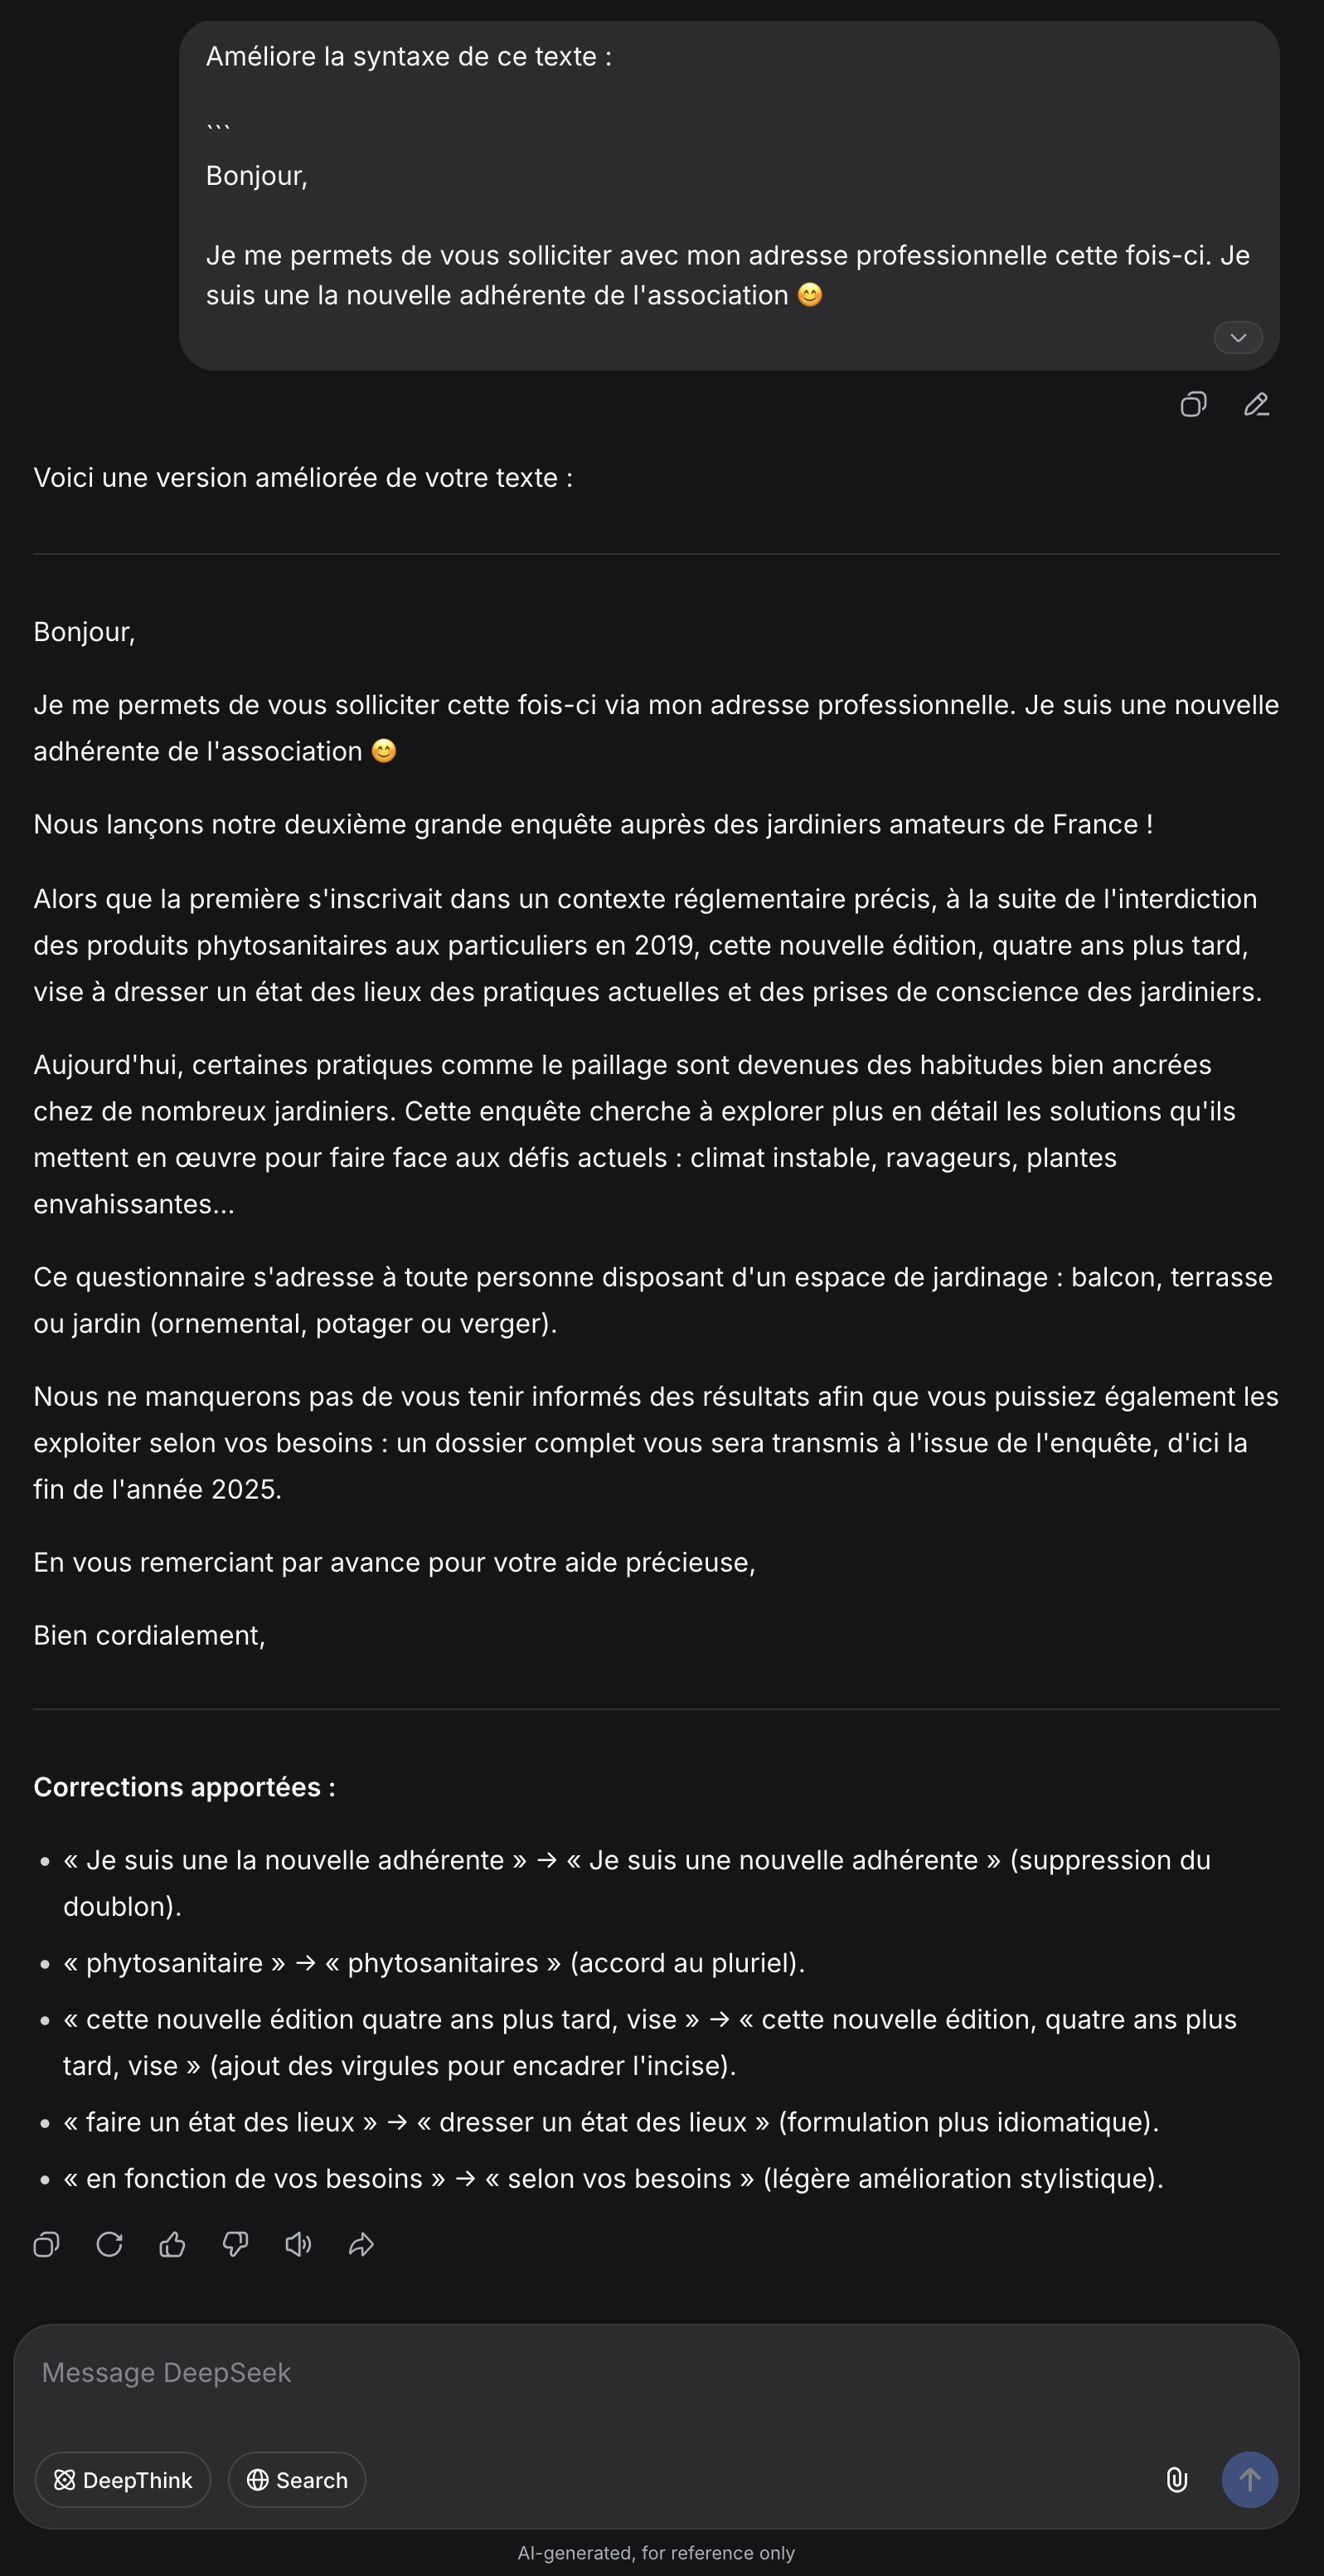
La calculadora diseñada para ilustrar este artículo estima que este simple mensaje enviado a DeepSeek emitió 0,28 g de CO₂ equivalente (gCO₂e) y consumió 0,06 mL de agua. Equivale a una bombilla encendida durante 6 minutos y a 1 gota de agua.
Sin embargo, la calculadora estima que este intercambio mucho más complejo con Claude emitió 7,48 gCO₂e y consumió 2 mL de agua. Equivale a una bombilla encendida durante 3 horas y 53 minutos, y a 40 gotas de agua.
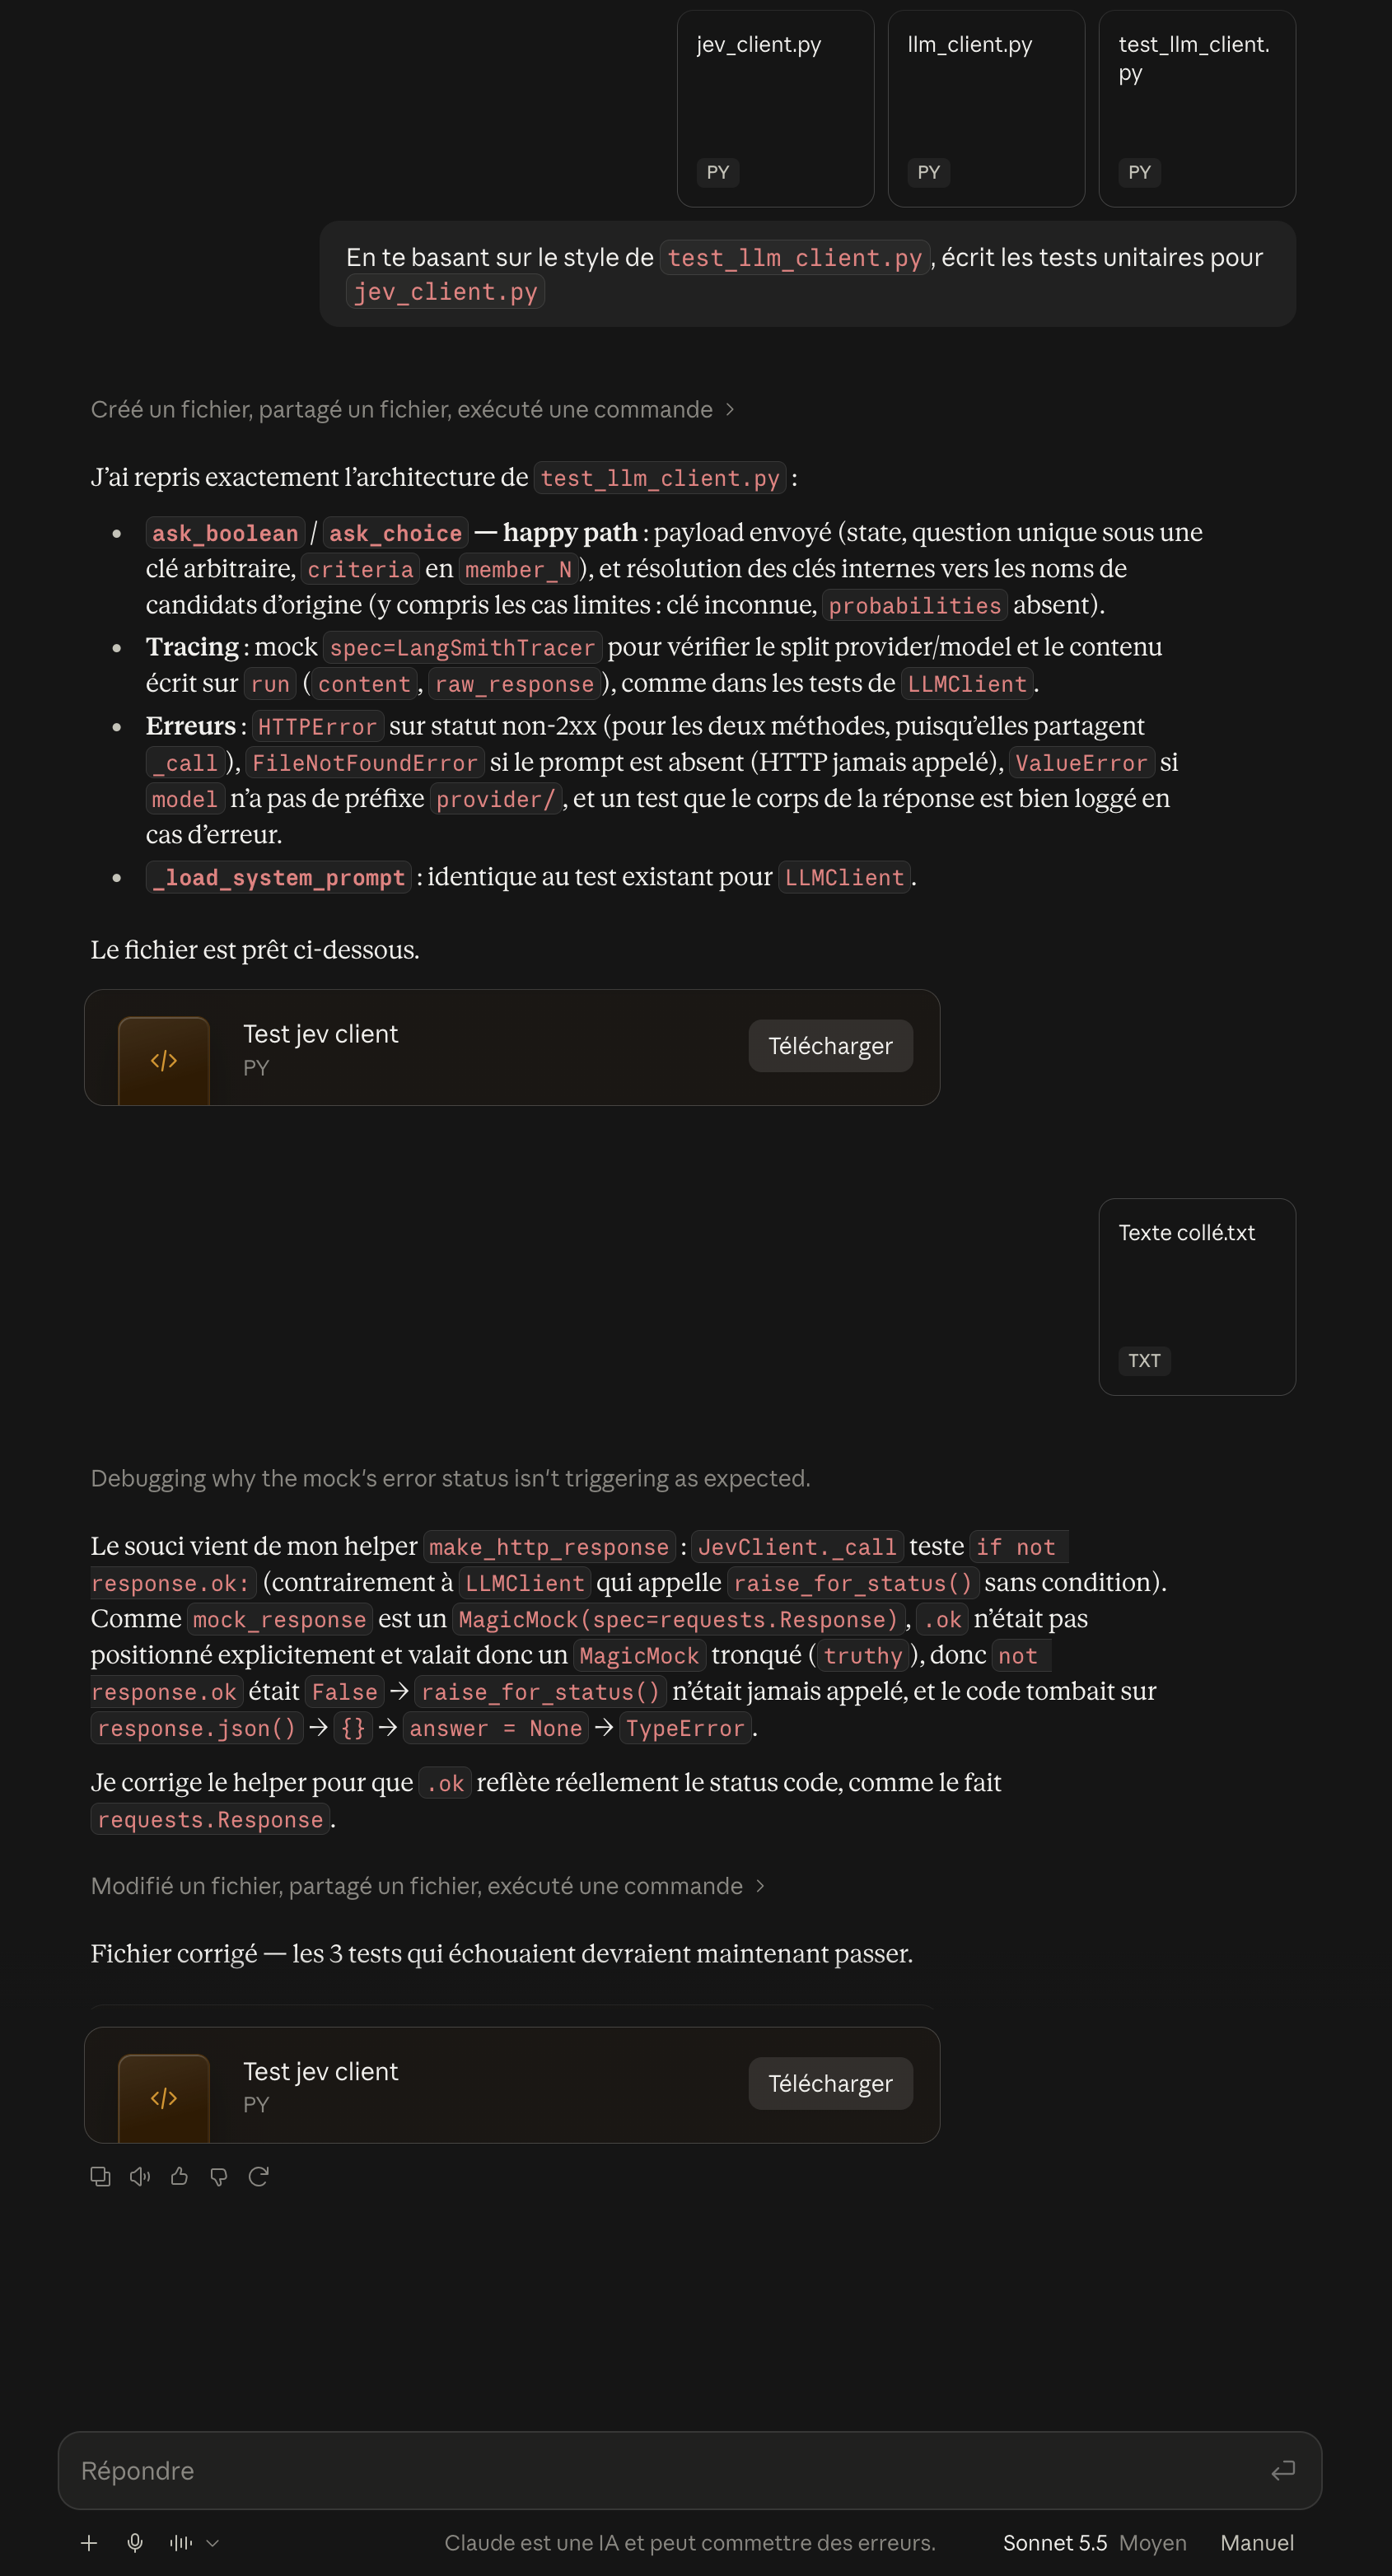
Las estimaciones tienen en cuenta el texto visible del chatbot, la electricidad utilizada para hacer funcionar la IA y el agua para refrigerar el data center. No tienen en cuenta el razonamiento de la IA, los bucles de acción, el entrenamiento del modelo, la fabricación del hardware informático y del data center, el uso de la red ni el agua consumida para producir la electricidad. Por tanto, el impacto ambiental global está claramente subestimado.
¿Pero cómo se explica una diferencia semejante?
En este artículo vamos a descifrar lo que se esconde detrás de estas cifras y a comprender qué hace variar realmente la huella ambiental de nuestras conversaciones con la IA. También se verá que adoptar buenas prácticas ambientales conduce, por lo general, a un uso más eficiente.
Introducción
En un contexto de cambio climático vinculado a las actividades humanas [2], hasta el papa se preocupa por los riesgos que genera la IA [3].
El informe «Energy and AI» publicado por la IEA en abril de 2025 prevé que la demanda mundial de energía de los centros de datos se duplicará y pasará a unos 945 TWh de aquí a 2030 —un nivel comparable al consumo anual de electricidad de Japón— y que debería alcanzar unos 1200 TWh de aquí a 2035 [4]. Las Naciones Unidas han publicado recientemente un informe sobre el impacto ambiental de la IA en términos de emisiones de carbono y consumo de agua [5].
Tanto las organizaciones como los particulares deben controlar su huella ambiental. Son necesarios consejos concretos y reales para reducir este impacto, tanto a nivel de usuarios como de desarrolladores. Pero para actuar de manera eficaz, primero hay que comprender algunos aspectos del funcionamiento de la IA.
Realicé trabajos de investigación sobre el impacto ambiental de la IA generativa durante 18 meses en AXA, lo que me permitió acumular numerosos conocimientos sobre el tema que hoy quiero compartir.
A lo largo de este artículo, comprenderá cuáles son los factores que más influyen en el impacto ambiental de la IA, cómo medirlo cuando es posible y cómo reducirlo como usuario final y como desarrollador.
También descubrirá esta calculadora, que permite medir el impacto de una de sus conversaciones con un chatbot (ChatGPT, Claude, Gemini, pero también Mistral, DeepSeek, etc.). Además, podrá simular la aplicación de ciertas buenas prácticas a esa misma conversación y así comprobar su pertinencia.
Esta calculadora no tiene como objetivo competir con los métodos de estimación existentes ni proporcionar una medida exacta. Su objetivo es ilustrar la eficacia de las buenas prácticas presentadas en este artículo.
Factores que influyen en el impacto ambiental de la IA generativa
Los principales impactos ambientales vinculados al uso de la IA que estudiaremos en este artículo son los siguientes:
- Las emisiones de gases de efecto invernadero (GEI) vinculadas a la electricidad y a las demás fuentes de energía necesarias para el funcionamiento de los data centers que ejecutan los modelos de IA;
- El consumo de agua para refrigerar los equipos informáticos de los data centers.
Podrían tenerse en cuenta otros impactos, pero, como el tema aún carece un poco de madurez, nos limitaremos a estos dos.
Los fundamentos: el Large Language Model (LLM)
En un chatbot como ChatGPT, un mecanismo permite generar respuestas que dan la impresión de una conversación real. Es el LLM: Large Language Model. Se trata de un modelo de inteligencia artificial generativa, entrenado con una enorme cantidad de textos para aprender las características y las relaciones entre las palabras y las frases. Su objetivo principal es predecir, a partir del contexto proporcionado, qué palabras son más probables a continuación.
Los tokens
Los LLM no procesan directamente palabras, sino tokens. Un embedder (herramienta de transformación) descompone las palabras en tokens antes del procesamiento. Una regla empírica útil consiste en considerar que un token corresponde generalmente a unos 4 caracteres en un texto inglés corriente. Esto equivale a aproximadamente tres cuartos de una palabra (así, 100 tokens corresponden a unas 75 palabras) [6].
Ejemplo de segmentación: «Impacting the environment» se descompone en 4 tokens: «Impact / ing / the / environment»
Los diseñadores de LLM utilizan embedders distintos, lo que significa que un mismo texto puede producir un número de tokens variable según el modelo.
Los tokens pueden dividirse en dos categorías:
- los tokens de entrada (también llamados: tokens de input, de instrucción, del usuario o enviados)
- los tokens de salida (también llamados: tokens de output, generados, del asistente o recibidos).
Cuantos más tokens debe procesar la IA, más energía consume
El número de tokens de salida es, en teoría, proporcional al consumo total de energía.
Ejemplo: Un intercambio que requiere procesar 10 tokens consume la mitad de energía que una solicitud que procesa 20 tokens.
Los tokens de salida suelen consumir más energía que los de entrada
Algunos estudios muestran que el procesamiento de un intercambio con un mensaje enviado largo (por ejemplo, 50 000 tokens) consume solo ligeramente más energía que mensajes enviados cortos [7]. Esto hace suponer que el consumo de un token de entrada es despreciable en comparación con el de un token de salida. En realidad, su consumo varía mucho en función de la longitud total del mensaje. Puede ser menor cuando el mensaje es corto, pero mayor cuando el mensaje es largo. Lo mismo ocurre con los tokens de salida [8] [9].
Modelo simplificado : Una solicitud con 1000 tokens de entrada y 50 tokens de salida consumirá en teoría menos energía que una solicitud con 50 tokens de entrada y 1000 tokens de salida.
Suponiendo que la mayoría de los intercambios con un chatbot son largos, no puede considerarse que el consumo de un token de entrada sea despreciable [10].
Regla general : cuantos menos tokens de salida procesa una solicitud, menos energía consumirá. Ocurre lo mismo con los tokens de entrada, pero en general de forma menos acusada que con los tokens de salida.
Los tokens de razonamiento se suman a los tokens de salida
Un modelo de razonamiento produce primero un texto de planificación en el que se apoya para elaborar su respuesta final. Los tokens generados por el modelo de razonamiento a veces no son visibles para el usuario. Un token de razonamiento consume tanta energía como un token de salida. Aumentan el número total de tokens procesados por el LLM y, por tanto, su consumo energético [11].
Así, comprendemos que el número de tokens procesados, en particular los tokens de salida, tiene un fuerte impacto en el impacto ambiental. Para medir este impacto y cuantificar su huella energética, de carbono e hídrica, pueden seguirse tres indicadores clave:
- las emisiones de GEI, expresadas en masa de dióxido de carbono equivalente (gCO₂e);
- el consumo de energía, expresado en vatios-hora (Wh);
- el consumo de agua, expresado en volumen (L o m³).
Estos indicadores se aplican tanto a los tokens de entrada como a los de salida.
El papel fundamental del centro de datos
Una IA generativa, como un LLM, es un programa que se ejecuta en un ordenador. Puede ser su equipo personal, pero generalmente se hace en centros de datos (data centers). Su funcionamiento requiere energía, lo que genera un impacto ambiental, medido aquí en gCO₂e/kWh.
Los distintos servicios que permiten utilizar un LLM, y que consumen energía, son los siguientes:
- Alojamiento en un data center público (Microsoft Azure, Amazon Web Services, Google Cloud Platform): la IA se ejecuta en servidores de un data center perteneciente a una empresa (cloud) en lugar de directamente en su ordenador. Estos servidores son muy potentes y permiten ejecutar modelos de IA que se han descargado o que se han desarrollado y entrenado por cuenta propia. En ese caso, se es propietario de la IA y se elige el proveedor de cloud y la región geográfica en la que se ejecutará.
- Alojamiento en un data center propio: generalmente reservado a las empresas, el principio de funcionamiento es similar al del cloud público: se posee la IA y se decide la ubicación de la máquina en la que hacerla funcionar.
- En los data centers de los proveedores de IA oficiales como OpenAI, Anthropic (Claude), Google, Mistral AI, Meta, DeepSeek, Z.ai, Moonshot AI o de agregadores como OpenRouter, Vercel, Groq y MammouthAI. Aquí no se controla nada del funcionamiento de la IA. Puede estar alojada en un data center privado o en un proveedor de cloud público (a nombre del proveedor o del agregador).
- En su ordenador: algunas IA recientes y pequeñas pueden funcionar directamente en su ordenador, ofreciendo rendimientos competitivos frente a los grandes modelos propietarios [12]. Así se controla el 100 % del consumo energético vinculado a su uso y se puede utilizar la IA generativa sin conexión.
El coste de la producción de electricidad por país
Cada país produce electricidad con un impacto ambiental variable. Para generar 1 kWh, una central emite GEI y consume agua.
Algunos organismos proporcionan los factores de emisión de carbono de cada país (en gCO₂e/kWh producido):
- la International Energy Agency (IEA), normalmente de pago pero accesible gratuitamente previa solicitud [13];
- la ADEME, gratuita pero que recoge los datos de la IEA de 2011 [14];
- Ember Energy, gratuita y que recoge datos de 2025 de la IEA, Eurostat, BP y UN [15];
- Spectrum IEEE, gratuita y por país o tipo de producción [16].
Según Ember Energy, estos factores pueden ir desde algo más de 20 (Islandia) hasta más de 800 gCO₂e/kWh (Mongolia). La ubicación de los servidores desempeña un papel principal en el impacto ambiental de la IA.
Los data centers deben refrigerarse
Durante el uso de los servidores, la electricidad recibida se convierte en calor. Para mantener su buen funcionamiento, los servidores de un data center deben mantenerse a una temperatura óptima. Para evacuar el calor, los data centers utilizan diferentes métodos de refrigeración [17], entre ellos:
- La refrigeración directa por aire exterior: Posible en regiones de clima fresco, este método ventila aire exterior para refrigerar los servidores. Consume electricidad principalmente para alimentar los ventiladores y no consume agua.
- La refrigeración adiabática: El aire caliente exterior se ventila y se enfría mediante la pulverización de finas gotas de agua que se evaporan en contacto con él. Este método consume tanto electricidad como agua.
- La refrigeración directa de los chips (Direct Chip Cooling): Circula agua por microtuberías entre los componentes de los servidores para refrigerarlos directamente. Aunque el agua no se consume, en algún momento del circuito debe enfriarse, lo que a menudo requiere energía. Además, esta agua puede ser movilizada por el data center durante períodos de alta demanda (por ejemplo, para el consumo humano o el riego agrícola en verano), lo que puede plantear problemas de competencia de usos.
El consumo de agua puede medirse
El WUE (Water Usage Effectiveness) es un indicador que mide la cantidad de agua consumida por los data centers [18]. Esta agua llamada consumida es en realidad evaporada a la atmósfera. El agua extraída del medio ambiente y devuelta más tarde no se tiene en cuenta en el cálculo de este indicador.
Fórmula: WUE (L/kWh) = Agua consumida (L) / Energía consumida por los servidores (kWh)
El WUE depende principalmente de la ubicación del data center y de sus métodos de refrigeración. Los que se encuentran en regiones áridas tienen un WUE generalmente más alto y, por tanto, movilizan más agua durante los períodos de mucho calor.
| WUE (L/kWh) | Fuente | Consumo de agua anual (m³) | Equivalente (piscinas olímpicas) |
|---|---|---|---|
| 0,12 | Amazon | Desconocido | -- |
| 0,255 | Microsoft | 8.170.000 | 3.268 |
| 0,29 | OVH France Roubaix | Desconocido | -- |
| 0,19 | Meta Texas Fort Worth | 195.000 | 78 |
Fuente: Informes ambientales
Índice de eficiencia energética: el PUE
Un mismo servidor consume la misma cantidad de energía, sea cual sea su ubicación. Sin embargo, la energía para mantenerlo a una temperatura óptima varía en función del clima. Así, se necesita más o menos energía para refrigerarlo según su ubicación.
El indicador que permite medir la eficiencia energética de un data center, en particular en lo que respecta a la refrigeración y al mantenimiento de la infraestructura, es el PUE (Power Usage Effectiveness) [19]. Representa la razón entre:
- el consumo total del data center;
- el consumo vinculado únicamente al funcionamiento de los servidores.
Fórmula: PUE = Consumo total del data center (kWh) / Consumo de los servidores del data center (kWh)
Ejemplos de interpretación:
- PUE = 1: ideal. Toda la energía se utiliza únicamente para hacer funcionar los servidores.
- PUE > 1: además de la energía para hacer funcionar los servidores, el data center consume también energía para refrigerarlos.
- PUE = 2: se consume tanta energía para alimentar los servidores como para refrigerarlos.
- PUE > 2: muy malo. Se consume más energía para refrigerar los servidores que para alimentarlos.
El PUE medio mundial es de 1,54 [20], mientras que el de Google es de 1,09 [21].
El PUE de los data centers es un criterio clave a la hora de elegir un proveedor cloud y la región de alojamiento.
La elección del modelo de IA utilizado
El tamaño del modelo
El tamaño de un modelo de lenguaje se mide por su número de parámetros. Cuantos más parámetros activados tiene un modelo durante su ejecución, mayor es su consumo energético por token. Este consumo es directamente proporcional al número de parámetros.
Ejemplo: un modelo con 100 000 millones de parámetros consume la mitad de electricidad para procesar un token que un modelo con 200 000 millones de parámetros [22].
Esta regla no se aplica necesariamente a todos los proveedores de modelos. En efecto, cada uno utiliza métodos de diseño diferentes, lo que influye en el consumo energético de los modelos [23]. Sin embargo, puede aplicarse generalmente a todos los de una misma familia: los modelos GPT-6 entre sí, los modelos Gemini 3 entre sí, etc. Así, aunque esta regla no sea universal para comparar todos los modelos entre sí, sigue siendo un indicador fiable para orientar la elección de un modelo dentro de un mismo proveedor.
Transparencia de los proveedores : Los modelos de código abierto (open source) muestran su número de parámetros. Pero el de los modelos de proveedores privados como OpenAI, Anthropic o Google nunca se divulga. No obstante, es posible ordenar por tamaño los modelos de un mismo proveedor gracias a sus denominaciones: luna, lite, small, nano, mini < terra, flash, medium < sol, pro, large, plus, max. Algunos trabajos intentan cuantificar este número de parámetros basándose en diversos métodos innovadores, como la comparación del volumen de conocimiento almacenado [24].
| Modelo | Proveedor | Parámetros estimados |
|---|---|---|
| gpt-5.5 | OpenAI | 5.300.000.000.000 |
| claude-fable-5 | Anthropic | 3.500.000.000.000 |
| gemini-2.5-pro | 3.000.000.000.000 | |
| grok-4 | xAI | 2.000.000.000.000 |
| claude-sonnet-4.6 | Anthropic | 760.000.000.000 |
Fuente: https://01.me/research/ikp/#/calibration#proprietary
También es posible estimar el tamaño de los modelos propietarios comparando su precio con el de modelos abiertos. Sin embargo, este método es muy incierto, ya que la bajada del precio puede significar una optimización en lugar de una disminución del número de parámetros [25].
Los modelos MoE solo activan los parámetros útiles
Un modelo MoE (Mixture of Experts) es un tipo de modelo que no utiliza la totalidad de sus parámetros durante su ejecución. Esto no lo hace menos eficaz; al contrario, activa únicamente los parámetros necesarios para generar la respuesta. Por ejemplo, un modelo MoE de 300 000 millones de parámetros puede activar solo 30 000 millones, lo que lo hace mucho menos voraz en energía que un modelo denso de 100 000 millones de parámetros [26]. Al activar un bajo número de parámetros, los modelos MoE reducen el consumo energético del procesamiento de un token.
Motores de inferencia
El consumo energético de un LLM durante la ejecución no está determinado únicamente por el propio modelo: depende también del motor de inferencia utilizado [27]. Un motor de inferencia es, en cierto modo, el software que hace funcionar un LLM en el momento en que se le plantea una pregunta. Si el LLM fuera el motor de un coche, el motor de inferencia sería el sistema que organiza y controla su funcionamiento. Algunos proveedores optimizan sus modelos para determinados motores de inferencia [28].
Medir el impacto ambiental de la IA generativa
Estado del arte
Hoy en día, organismos privados como Meta, Mistral, Google, DeepSeek o Alibaba ponen a disposición modelos de IA de forma open-source u open-weights (descargables, pero cuyo proceso de diseño es confidencial). Por tanto, en teoría es posible medir su huella ambiental con certeza.
Por ejemplo, el ML.ENERGY Leaderboard [29] mide directamente el consumo eléctrico de los modelos con su herramienta Zeus [30]. Esta iniciativa incluso es citada por OpenAI [31].
Sin embargo, los modelos más potentes pertenecen hoy a OpenAI, Google y Anthropic. Estos modelos propietarios son accesibles principalmente mediante API que impiden la medición directa de la energía por parte de organismos externos. Google estima que una consulta mediana a Gemini consume 0,24 Wh de energía, emite 0,03 gCO₂e y consume 0,26 mL (unas cinco gotas) de agua. El impacto energético por consulta equivale a ver la televisión durante menos de nueve segundos [32]. El CEO de OpenAI afirma que una consulta media dirigida a ChatGPT consume aproximadamente 0,34 Wh de energía y 0,3 mL (6 gotas) de agua [33]. Sin embargo, ninguno de los dos proveedores precisa el número exacto de tokens por prompt ni el número de parámetros de los modelos utilizados. Esta falta de transparencia no permite, por tanto, interpretar estos valores con rigor ni comparar el impacto de los modelos.
Algunos actores intentan estimar el impacto ambiental de los modelos cerrados recurriendo a aproximaciones [34]. Análisis independientes estiman que una consulta consume entre 0,3 y 29 Wh [35] [36].
Otros actores sin ánimo de lucro han desarrollado métodos de estimación que cubren un amplio perímetro, basados en estimaciones para los modelos cerrados [37] [38] o en datos reales medidos en modelos abiertos [39].
Sin embargo, aunque no se cuestione el profesionalismo de estos organismos, estas estimaciones deben interpretarse con cautela, ya que se basan en gran medida en hipótesis difícilmente verificables. Por ejemplo, un estudio [40] citado 526 veces, entre otros en artículos de revistas científicas serias como Nature [41], se basa en una cita de un miembro de la dirección de Alphabet (Google) sin pruebas que la respalden [42].
Herramientas y calculadoras
Para ayudar a intentar medir el impacto ambiental de la IA generativa, se han desarrollado herramientas y calculadoras:
Mi calculadora del impacto ambiental de su conversación con la IA
Desarrollada especialmente para ilustrar las buenas prácticas compartidas en el próximo capítulo de este artículo, esta calculadora está concebida para ser sencilla de usar y accesible al gran público. Se basa en un perímetro restringido de la metodología de Ecologits en el que algunos valores hipotéticos se han sustituido por valores medidos. También se han añadido variables adicionales para poner de relieve las palancas que permiten reducir la huella ambiental del usuario.
Pruébela ahora mismo copiando y pegando algunos fragmentos de su última conversación con una IA: https://felixmortas.com/ai-inf-calculator
Esta calculadora, como cualquier método de estimación, presenta limitaciones:
- No tiene en cuenta los tokens de razonamiento invisibles. Una próxima versión podría estimar su proporción respecto al número de tokens de salida visibles, en función del nivel de esfuerzo de razonamiento.
- Los agentes conversacionales probablemente realizan varias pasadas de procesamiento, en particular en bucles. Por tanto, el texto de entrada puede procesarse varias veces. La calculadora no tiene en cuenta estos bucles ni el reprocesamiento de tokens que implican.
- El coste energético de un token de salida depende del número de tokens generados previamente. En la calculadora se supone que todos los tokens de salida tienen el mismo coste energético [8].
Otras buenas herramientas
- Zeus Project por ML.ENERGY: para medir directamente la energía consumida en la máquina [30], y el ML.ENERGY Leaderboard para comparar el consumo energético de los modelos abiertos [29].
- Un modelo de datos abiertos e interconectados para construir escenarios de huella de carbono, que mejora la calidad y la transparencia de los datos desde el diseño [43].
- CodeCarbon: una biblioteca de Python para medir en directo el consumo energético de la máquina (ordenador personal o servidor) [44]. Ojo, porque no tiene en cuenta el código ejecutado a través de API.
- EcoLogits por CodeCarbon: una calculadora web y una biblioteca de Python para estimar la huella de carbono de la IA generativa a través de API, utilizando el token como unidad de medida [45]. La herramienta crea buenas sinergias con CodeCarbon.
- Impact'IA por la SNCF: una calculadora con un perímetro más amplio que Ecologits, pero con numerosas hipótesis que aumentan considerablemente la incertidumbre [38].
- LLM Perf Leaderboard por Hugging Face: un comparador del rendimiento de modelos abiertos, que incluye la energía por token generado [39].
- Otros recursos, como herramientas o artículos, están recopilados en el repositorio de GitHub [46] de un miembro de la organización CodeCarbon: https://github.com/samuelrince/awesome-green-ai
- A veces es imposible medir directamente el consumo energético de las máquinas. Sin embargo, este está muy ligado al tiempo de ejecución del modelo [23], lo que lo convierte en un parámetro utilizable para medir el impacto ambiental de un LLM alojado.
Reducir el impacto ambiental aplicando buenas prácticas
En este capítulo descubrirá qué buenas prácticas conviene aplicar para reducir su impacto ambiental relacionado con la IA, y por qué aplicarlas puede incluso mejorar su eficacia.
Existen buenas prácticas adaptadas a dos categorías de público:
- El usuario final: afectan a la manera en que se utiliza la aplicación de IA.
- El desarrollador de IA: influyen en la manera en que funciona la aplicación de IA.
En ambos casos, estas buenas prácticas buscan minimizar su huella ecológica y, al mismo tiempo, optimizar su rendimiento.
Algunos actores como la ONU también proponen palancas de reducción que se presentarán en este capítulo [5].
Como usuario de un chatbot
Priorizar una búsqueda en un motor de búsqueda
Si la respuesta que espera a su pregunta es sencilla (por ejemplo, el número de habitantes de una ciudad o la familia de una planta), es preferible hacer una búsqueda en un motor de búsqueda (Google, Ecosia, Bing, Qwant, Brave, DuckDuckGo).
Si tiene el reflejo de formular su pregunta en su chatbot con palabras clave para ahorrar tiempo, tenga en cuenta que puede introducir directamente esas palabras clave en su motor de búsqueda. La respuesta será igual de rápida y accesible a través de varias fuentes. Ejemplos: «Planeta más grande sistema solar», «velocidad de la luz».
Google estima que una búsqueda media en su motor de búsqueda consume 0,3 Wh de energía y emite 0,2 gCO₂e en 2009 [47], pero es muy probable que este valor ya no sea válido. Un estudio reciente estima los nuevos valores en 0,03 Wh y 0,02 gCO₂e, es decir, 10x menos que antes [48]. Como comparación, Mistral AI estima que una consulta dirigida a su modelo Mistral Large 2 con 400 tokens de salida emite 1,14 gCO₂e [22].
Atención: en sus búsquedas con Google u otros motores, la funcionalidad de búsqueda por IA automática (AI Overview) está activada por defecto. Debe desactivarla en los ajustes para que esta buena práctica sea válida y elegir usted mismo cuándo usar la IA en sus búsquedas.
Utilizar un modelo con pocos parámetros activados
Cuando use un chatbot, elija el modelo más pequeño, con el menor número de parámetros activados. Es suficiente para realizar con precisión muchas tareas [49] [50].
La mayoría de los proveedores de IA no comunican ni el nombre exacto del modelo utilizado ni el número de parámetros que contiene. Sin embargo, a modo de orientación, tenga en cuenta que los modelos cuyos nombres incluyen términos como «flash», «lite», «rápido», «nano», «mini», «quick» o «small» suelen ser los que activan el menor número de parámetros por token procesado.
Recomendaciones para elegir el modelo en función de la tarea que se va a realizar:
- Pequeño: profundizar en un tema, reformular o resumir un texto, generar un fragmento de código básico, clasificar, extraer texto.
- Intermedio: planificar, diseñar una arquitectura, generar código dentro de un proyecto, realizar un tratamiento no estandarizado.
- Grande: resolver un problema complejo de matemáticas, ciencias o ingeniería, diseñar una arquitectura compleja, realizar una planificación compleja, analizar expedientes voluminosos con fuentes contradictorias.
Ya lo habrá entendido: los grandes modelos están sobredimensionados para muchos casos de uso.
Con los modelos GPT-5 en ChatGPT, no puede elegir manualmente el modelo utilizado. Un primer modelo, llamado «router», determina automáticamente el tamaño del modelo que procesará su mensaje. Para los usuarios gratuitos, todas las consultas se envían al modelo más pequeño [51].
Para incitar al router a dirigir su mensaje a un modelo en concreto, puede incluir palabras clave como: «Responde de forma sencilla» o «Sin razonar» para utilizar un modelo pequeño. «Piensa paso a paso» o «Razona antes de responder» para utilizar un modelo más potente o un razonamiento [52].
Reducir el esfuerzo de reflexión
Se recomienda utilizar la funcionalidad de razonamiento únicamente cuando la respuesta a su consulta requiera un análisis complejo, no trivial, y deba descomponerse en varios pasos para garantizar la mejor calidad posible. Puede elegir activar o no el razonamiento en los chatbots de Google, DeepSeek y Mistral.
Algunos modelos, como GPT o Claude, permiten configurar distintos niveles de esfuerzo. Este parámetro determina el número de tokens de razonamiento y de salida que genera. Aunque a menudo se considera que un razonamiento más largo conduce a mejores resultados, no siempre es así. El rendimiento tiende primero a mejorar a medida que aumenta el esfuerzo, hasta alcanzar un punto óptimo y, en algunos casos, empeorar más allá de ese umbral [53]. Por tanto, es preferible elegir un nivel de esfuerzo bajo o moderado.
Prompt engineering
Esta sección explica la importancia del prompt/context engineering: cómo proporcionar un contexto útil al chatbot eliminando el ruido (es decir, la información innecesaria) para que realice su tarea con precisión y genere una respuesta en el formato deseado.
Según los principales proveedores de modelos, entre ellos OpenAI [54], la estructura óptima de un prompt se basa en varios elementos clave, entre ellos:
- Contexto: la parte que suele ser más larga, que se puede reducir considerablemente para minimizar el número de tokens de entrada y aclarar la petición.
- Tarea: generalmente formulada en una frase.
- Entregable: breve, pero esencial para limitar el número de tokens de salida.
Optimizar el contexto para reducir los tokens de entrada
Hemos visto anteriormente que los tokens de entrada también influyen en el consumo energético de la consulta [10]. Por tanto, se recomienda limitar el contexto para reducir el impacto ambiental, pero también para mejorar la calidad de la respuesta.
Optimizar el entregable para reducir los tokens de salida
Hemos visto anteriormente que el impacto energético de los tokens generados en la salida es mayor que el de los tokens de entrada [7]. Por tanto, suele ser más eficaz, desde el punto de vista energético, alargar el prompt enviado para intentar reducir la longitud de la respuesta.
En la mayoría de los casos, una respuesta corta y concisa basta y evita perderse en explicaciones innecesarias.
Ejemplos de instrucciones para limitar la longitud de la respuesta:
- Para corregir faltas de ortografía en un texto largo: «Indica únicamente las correcciones que hay que hacer, sin explicaciones y sin copiar de nuevo todo el texto.»
- Para corregir código: «Reescribe únicamente las partes que hay que modificar sin reproducir todo el código. No des explicaciones.»
- Para reformular un párrafo dentro de un texto: «Reescribe únicamente el párrafo que hay que modificar, sin copiar de nuevo el resto del texto.»
Le corresponde a usted determinar lo que necesita para obtener la respuesta esperada, y nada más si no es necesario.
Consejo: algunos chatbots, como Claude, ofrecen seleccionar el tipo de respuesta. Elija las opciones «cortas» o «concisas».
Por el contrario, el uso de ciertos verbos de acción como «justifica», «explica», «analiza» o «recomienda» tiende a aumentar la cantidad de texto generado [55].
Detener la generación
Si desde el comienzo de la respuesta del chatbot comprueba que no se corresponde en absoluto con lo que espera, interrúmpala de inmediato pulsando el botón «Stop» (generalmente representado por un cuadrado relleno ⏹️).
Esta sencilla acción permite reducir el número de tokens generados en la salida al evitar una respuesta inútil.
Modificar la petición inicial en lugar de enviar un mensaje nuevo
Cuando la respuesta generada es incompleta, interrumpida o insatisfactoria (un elemento olvidado en el contexto, un detalle impreciso, una parte que hay que eliminar), es preferible modificar el mensaje inicial en lugar de enviar uno nuevo para afinar su petición.
Con cada nuevo mensaje enviado, se vuelve a enviar todo el historial de la conversación al modelo. Esto aumenta considerablemente el número de tokens de entrada y, por tanto, el impacto ambiental. Además, un historial demasiado largo introduce ruido (información innecesaria), lo que reduce la calidad de las respuestas. Cuanto más limitados y pertinentes sean los tokens de entrada, mejor será la respuesta del chatbot.
Ejemplo concreto: Si la respuesta del chatbot no tiene en cuenta un elemento importante, no envíe un nuevo mensaje pidiéndole que rehaga su respuesta teniendo en cuenta un parámetro adicional. Es preferible modificar el mensaje inicial para integrar esa precisión. Así, la respuesta se regenerará con un contexto más completo, sin sobrecargar el historial.
Caso particular: las pequeñas correcciones Si la respuesta es larga y solo requiere una pequeña modificación:
- No modifique el prompt inicial: se regeneraría una respuesta completa y habría un mayor impacto debido a los tokens de salida.
- Pida al chatbot que corrija únicamente la parte afectada sin reescribirlo todo. Ejemplo: «Corrige únicamente el tercer párrafo, sin copiar de nuevo el resto del texto.»
Esta buena práctica exige encontrar el mejor compromiso entre:
- Regenerar una respuesta modificando el mensaje inicial, lo que permite mantener un contexto conciso, pero puede generar más tokens de salida;
- Añadir un mensaje, lo que permite reducir los tokens de salida, pero aumenta la cantidad de tokens de entrada con cada nuevo mensaje.
Conversation engineering: crear ramas
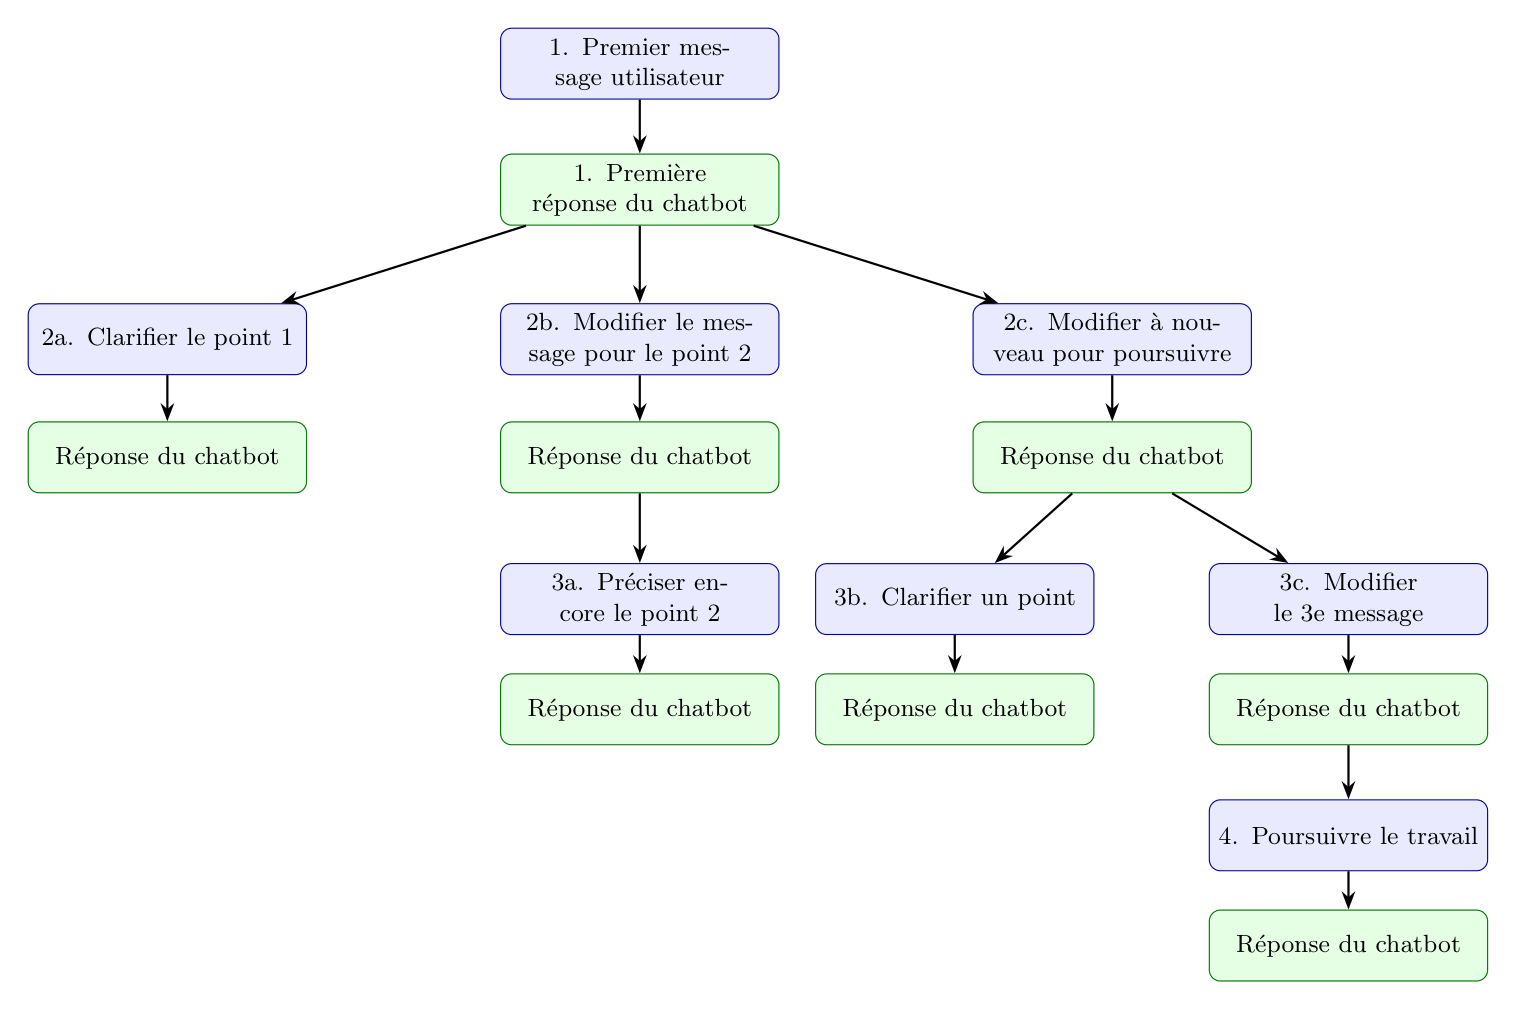
Para mantener un contexto mínimo y útil, una técnica eficaz consiste en crear ramas dentro de una conversación. No toda la información intercambiada con el chatbot es necesariamente útil para responder a una nueva petición.
Si pide al chatbot que aclare algún punto de su respuesta, pero su siguiente mensaje no necesita esa aclaración, es preferible modificar la pregunta inicial en lugar de añadirla a la conversación. Así puede crear ramas distintas para cada tema y limitar el contexto a lo estrictamente necesario.
Ejemplo concreto:
- Le hace una pregunta a un chatbot sobre un tema concreto.
- Responde abordando varios puntos, algunos de los cuales no le quedan claros.
- Le pide que profundice en el punto 1.
- Para profundizar después en el punto 2, modifica el prompt inicial para pedirle directamente explicaciones sobre ese punto, en lugar de plantear una nueva pregunta en la conversación.
- Por último, si quiere pasar a la acción a partir de la respuesta inicial, pídale que planifique el proyecto modificando el prompt dedicado al punto 2, en lugar de enviar una nueva pregunta.
En este punto, su conversación cuenta con 3 ramas:
- La primera: su pregunta inicial sobre el tema y una profundización en el punto 1 que no había entendido.
- La segunda: su pregunta inicial sobre el tema y una profundización en el punto 2 que no había entendido.
- La tercera: su pregunta inicial sobre el tema y la petición de planificación.
Cada rama trata, por tanto, un aspecto específico del proyecto, lo que permite:
- Conservar una única conversación para todo el proyecto.
- Evitar que el contexto se contamine con información innecesaria.
- Ahorrar tokens enviados al modelo.
- Crear un método de prompting jerarquizado y especializado.
Crear una nueva conversación para cada tema nuevo
Hemos comprobado que cada nuevo mensaje enviado provoca el reenvío íntegro del historial de la conversación al chatbot. Por tanto, es preferible iniciar una nueva conversación cuando se quiere abordar un tema sin relación con el anterior [56].
Tiene dos opciones:
- Crear una nueva conversación dedicada al nuevo tema.
- Modificar el primer mensaje de la conversación existente para introducir el nuevo tema.
Si elige la segunda opción, reduce el número de conversaciones en su historial, lo que permite mantener un entorno limpio y organizado.
También puede reutilizar la respuesta de un chatbot inyectándola en una nueva conversación dedicada a otra tarea, en lugar de continuar en la conversación inicial. Este enfoque permite, una vez más, limitar el tamaño del contexto.
Eliminar las conversaciones inútiles
Cuando envía un mensaje a un chatbot, incluso antes del historial de sus mensajes, se incluyen varios elementos: el prompt del desarrollador, el prompt del sistema, información contextual (país, hora, idioma, navegador, etc.), así como un resumen de cada una de sus conversaciones guardadas [57]. Estos resúmenes añaden un contexto que no siempre es útil para el chatbot. Elimine sus conversaciones antiguas cuando ya no le sean útiles.
Vaciar la memoria a largo plazo
Cuando le pide a un chatbot que recuerde una información durante una conversación, esta se incluirá sistemáticamente en las nuevas conversaciones. Es lo que se conoce como memoria a largo plazo [58]. Para optimizarla, utilice el menú dedicado si existe; si no, cree una conversación específica en la que le pida al chatbot que liste la información que ha memorizado y elimine la que ya no sea pertinente.
Como empresa que desarrolla un agente
Priorizar los algoritmos y la IA clásica frente a la IA generativa
Cuando sea suficiente, opta por tecnologías menos complejas. En muchos casos, bastan simples algoritmos de decisión o IA clásicas de predicción o clasificación.
Utilizar modelos pequeños especializados
Hemos visto antes que el número de parámetros activados de un modelo influye de manera importante en el impacto ambiental del procesamiento de un token.
Dé prioridad al uso de modelos pequeños y especializados. A veces incluso permite obtener resultados más precisos que con grandes modelos generalistas [50] [59] En Hugging Face hay disponibles modelos ya especializados en una tarea mediante fine-tuning. Es preferible utilizarlos antes que realizar un nuevo fine-tuning.
Prompt engineering para reducir el número de tokens de salida
Del mismo modo que el usuario puede limitar los tokens de salida, el desarrollador puede precisar explícitamente la forma esperada de la respuesta en el prompt del sistema. Este es tenido en cuenta por el modelo incluso antes de la primera consulta del usuario y permite reducir sistemáticamente el número de tokens de salida.
Context engineering para reducir el número de tokens de entrada
Existen numerosas técnicas para limitar el contexto conservando solo la información útil.
Ejemplos:
- Tras una conversación de 10 mensajes, se puede recurrir a un modelo pequeño para resumir los intercambios. Este resumen puede sustituir al historial en los siguientes intercambios.
- En un proceso de varias etapas, los pasos pueden descomponerse para proporcionar al modelo únicamente la información estrictamente necesaria en cada etapa.
Puede diseñar muchos otros métodos para limitar el contexto enviado al modelo.
Fine-tuning vs Few-shots-ejemplos
Para que un modelo produzca una salida que se ajuste a lo esperado, es posible añadir ejemplos o realizar fine-tuning. Si el agente no se utilizará de manera intensiva*, se recomienda añadir ejemplos al contexto* (one-shot o few-shots). En cambio, para un uso masivo, es preferible reducir el número de tokens de entrada recurriendo al fine-tuning. Este permite al modelo comprender el tipo de respuesta esperado sin necesidad de proporcionarle ejemplos en cada consulta. Sin embargo, el fine-tuning tiene un coste ambiental y económico elevado.
Elegir entre few-shots y fine-tuning Para determinar el umbral a partir del cual el fine-tuning resulta más rentable, puede:
- Convertir en tokens las instrucciones de la tarea y los few-shots.
- Estimar el coste por consulta en función de ese número de tokens.
- Comparar el coste acumulado de todas las consultas con few-shots con el coste de todas las consultas sin few-shots sumado al coste fijo del fine-tuning.
Cuando el coste total de las consultas sin few-shots sumado al del fine-tuning sea inferior al de las consultas con few-shots, opta por el fine-tuning.
Alojar el modelo en un data center de bajo impacto energético e hídrico
Cuando decida alojar usted mismo su modelo en un proveedor de nube pública, puede seleccionar una región con una buena puntuación energética e hídrica: factor de emisión bajo, PUE y WUE bajos durante todo el año.
Punto de vista de las emisiones de carbono
Basándose en los datos proporcionados por Ember Energy, preseleccione un país con un factor de emisión bajo como Islandia, Noruega, Suiza o Francia.
Los principales proveedores de nube indican la ubicación de sus data centers por región:
- Amazon Web Services: https://aws.amazon.com/fr/about-aws/global-infrastructure/regions_az/
- Microsoft Azure: https://learn.microsoft.com/en-us/azure/reliability/regions-list?tabs=all
- Google Cloud Platform: https://datacenters.google/locations/
- Salesforce: https://help.salesforce.com/s/articleView?id=000396845&type=1
- OVH: https://www.ovhcloud.com/en/datacenter/
Una vez preseleccionada la región, tenga en cuenta el PUE del proveedor. Puede encontrar estos valores por región para los principales proveedores de nube:
- Amazon Web Services: https://sustainability.aboutamazon.com/products-services/aws-cloud
- Microsoft Azure: https://datacenters.microsoft.com/sustainability/efficiency/
- Google Cloud Platform: https://datacenters.google/efficiency/
- OVH: https://www.ovhcloud.com/sites/default/files/external_files/kpis_fy25.pdf
Punto de vista del consumo de agua
Compruebe que la región preseleccionada no corre riesgo de sequía. Para evaluar los riesgos relacionados con la disponibilidad de agua, el World Resources Institute (WRI) ofrece un mapa de las regiones con alto riesgo de sequía: https://www.wri.org/aqueduct/tools.
Por último, fíjese en el WUE. Cuando falte este indicador, considere el WUE de la región de otro proveedor:
- Amazon Web Services: https://sustainability.aboutamazon.com/products-services/aws-cloud/ ;
- Microsoft Azure: https://datacenters.microsoft.com/sustainability/efficiency/ ;
- Google Cloud Platform: enlace https://services.google.com/fh/files/misc/measuring_the_environmental_impact_of_delivering_ai_at_google_scale.pdf ;
- OVH: https://www.ovhcloud.com/sites/default/files/external_files/kpis_fy25.pdf.
Motor de inferencia
Algunos proveedores optimizan sus modelos para motores de inferencia específicos [28]. El motor adecuado puede indicarse en la ficha de presentación del modelo.
Utilizar la caché
La funcionalidad de caché permite almacenar y reutilizar los cálculos de atención, así como los tokens de un prompt ya procesado, evitando así tener que recalcularlo todo en cada consulta.
Casos de uso optimizados con la caché:
- Repetición de un contexto voluminoso: por ejemplo, cuando envía con frecuencia la misma documentación en el contexto, o el historial completo de una conversación (caso de un chatbot).
- Agentes autónomos: los agentes que realizan llamadas sucesivas apoyándose en el mismo prompt del sistema (instrucciones básicas, herramientas disponibles, ejemplos de guía) y en un estado compartido.
- Asistentes de código: análisis de un repositorio de código voluminoso e idéntico en cada mensaje.
Para que una caché sea eficaz, las consultas deben estar poco espaciadas en el tiempo y el prefijo del prompt (la parte que se va a almacenar en caché) debe ser estrictamente idéntico de una consulta a otra. El más mínimo espacio o carácter modificado al principio del texto invalidará total o parcialmente la caché existente.
Procesamiento por lotes (Batch processing)
El batch processing consiste en enviar un gran número de consultas para que se procesen simultáneamente. Este método optimiza la inferencia del modelo y permite reducir de manera significativa el coste energético y económico [60].
Los proveedores de modelos mediante API suelen ofrecer el batch processing a mitad de precio respecto al procesamiento clásico. Aunque no existen datos precisos en la literatura que cuantifiquen esta reducción, se puede suponer que la variación del precio está correlacionada con la del impacto energético.
Envíe periódicamente todas las consultas en batch si no necesita las respuestas del modelo en tiempo real, si el volumen de consultas es grande y si son independientes entre sí.
Modelos recientes
Manténgase informado sobre los nuevos modelos, ya que algunos pueden ofrecer un rendimiento equivalente al de su modelo actual con un impacto menor, gracias a una optimización o una innovación.
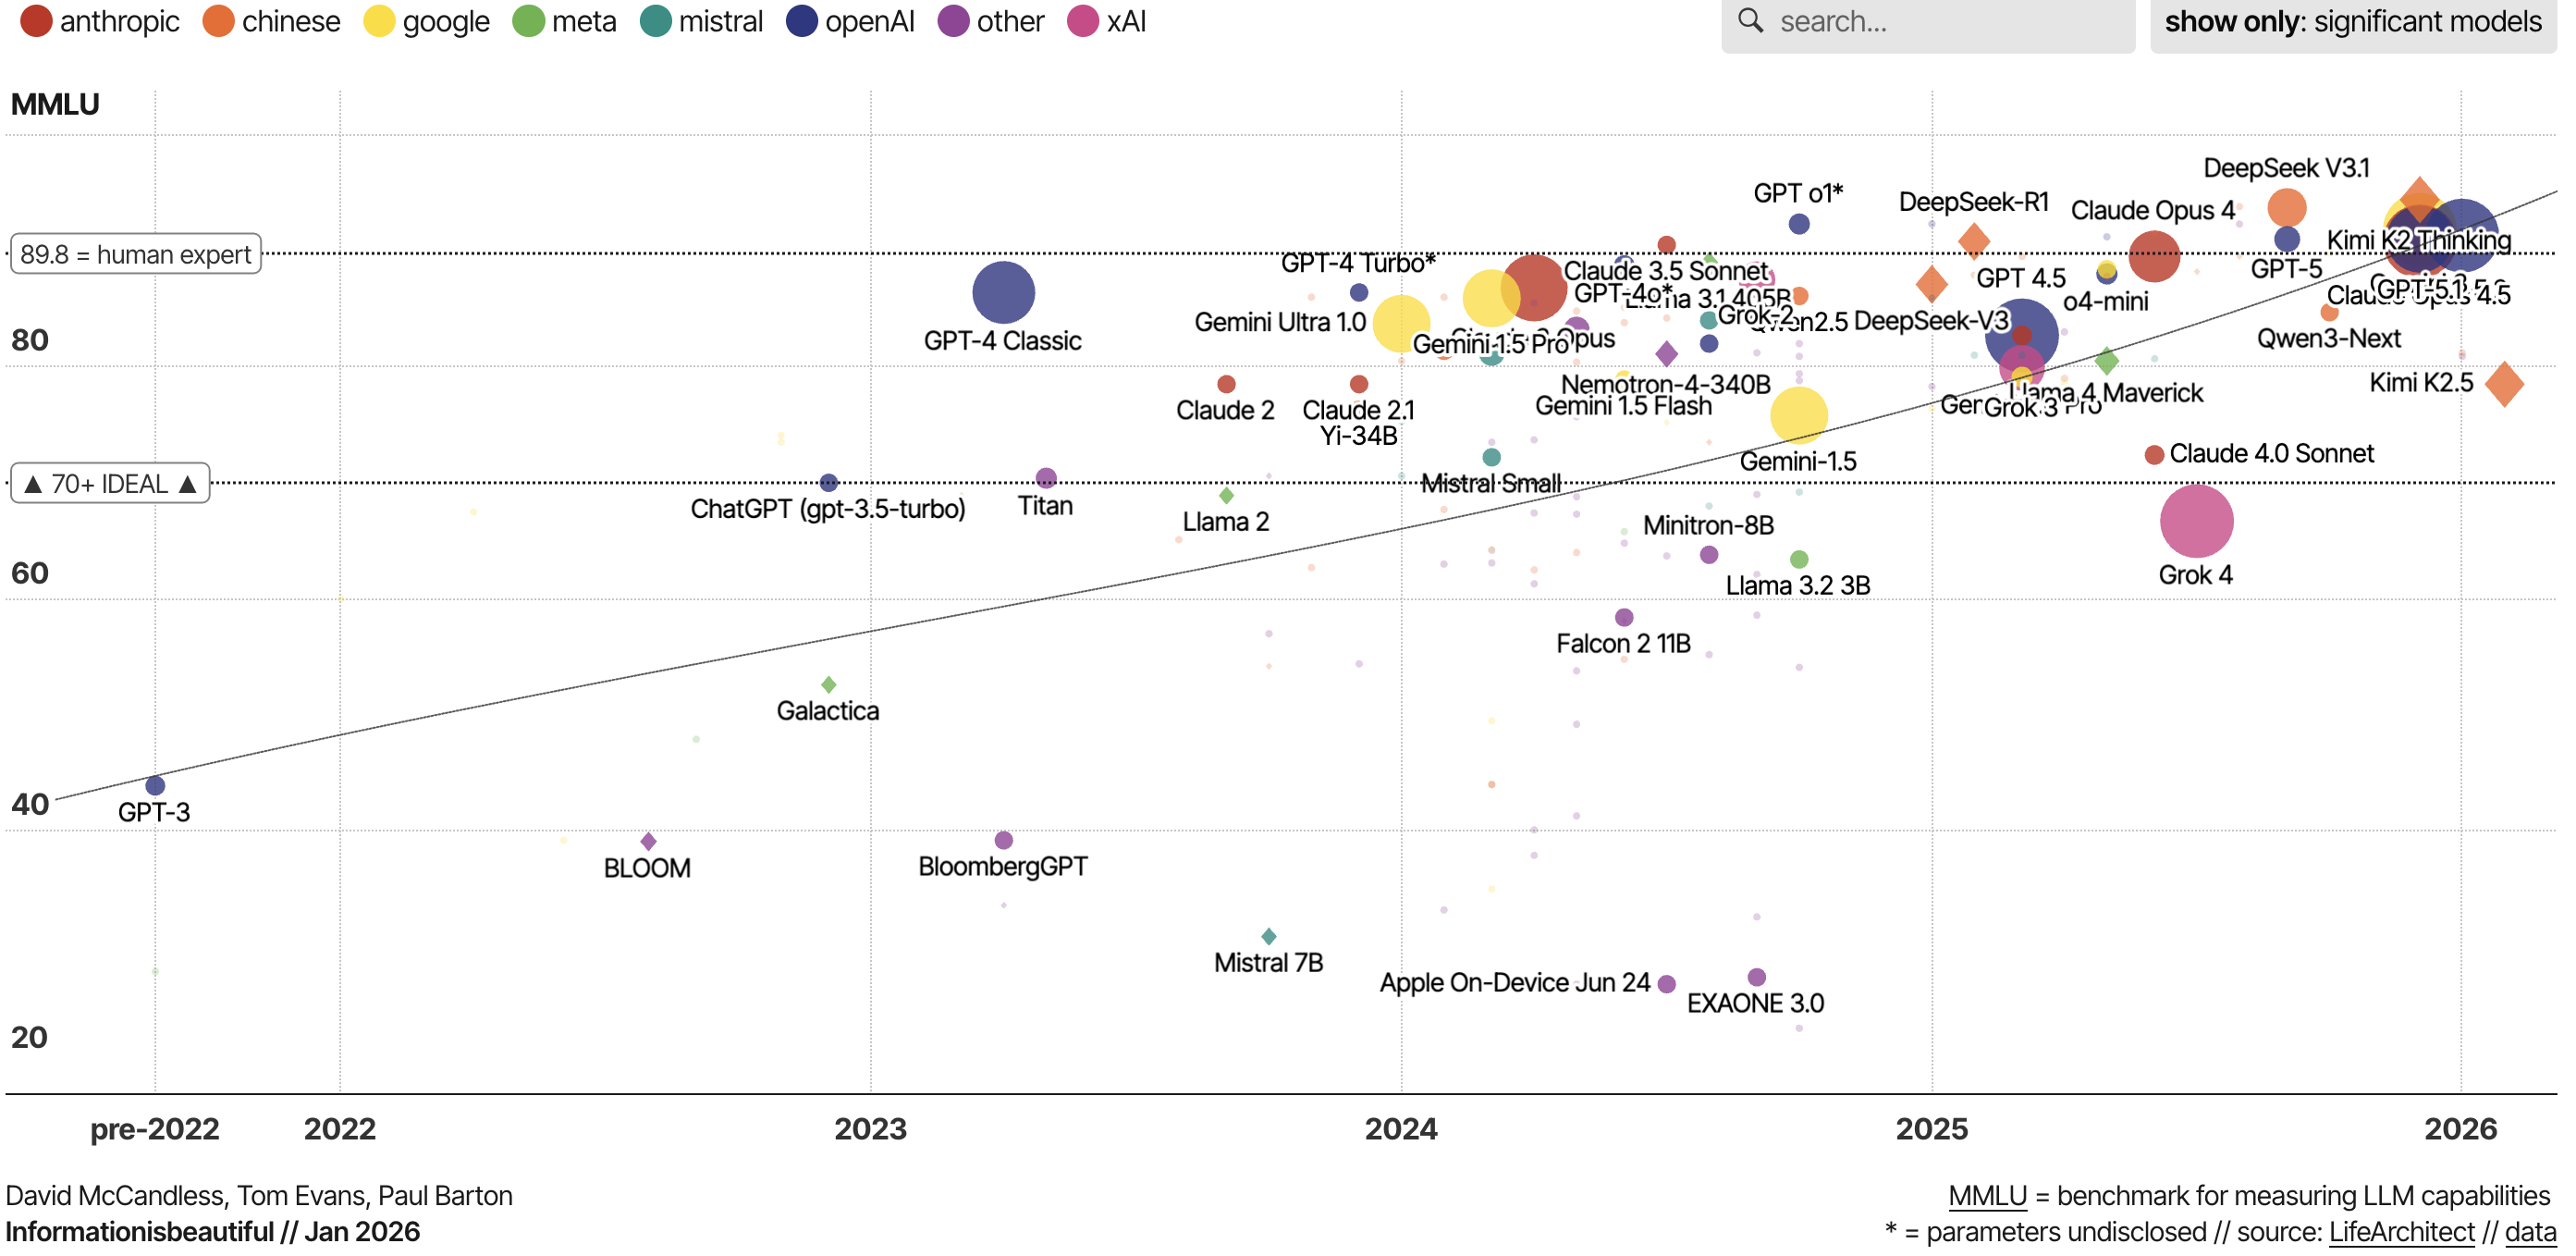
Panorama mundial de los LLM y de su rendimiento [61]
En la generación de imágenes, por ejemplo, un estudio sugiere que la elección del tipo de modelo debería tener en cuenta la longitud prevista de la salida: los modelos autorregresivos (los más utilizados) siguen siendo preferibles para las respuestas cortas (menos de 1024 tokens), mientras que los modelos de difusión ofrecen ventajas indiscutibles para las tareas de generación más largas [62].
Atención: cambiar de modelo puede implicar una nueva fase de desarrollo (evaluación, fine-tuning) con un impacto ambiental significativo. Además, optimizar una tecnología tiende más bien a aumentar su impacto global, porque se vuelve poco costosa y, por tanto, se utiliza mucho más. Es el efecto rebote [63].
«La quantization»: reducir la precisión de los cálculos reduce las necesidades de energía
«Quantizar» un modelo consiste en reducir la precisión de sus cálculos. Se pasa de números de coma flotante a números enteros. Al reducir la precisión de los cálculos, se puede, en determinadas condiciones, reducir la cantidad de energía consumida por el modelo [64] [60]. Por supuesto, esta reducción de decimales conlleva una pérdida de precisión en los cálculos. Pero hoy en día es posible utilizar modelos «quantizados» conservando muy buenos rendimientos.
La destilación: cuando el alumno supera al maestro
Una técnica que permite reducir el tamaño de los modelos y, por consiguiente, su impacto durante la ejecución es la destilación del conocimiento. Esta técnica fue la que se utilizó para crear DeepSeek con una fracción del coste energético de ChatGPT [65]. Consiste en utilizar un modelo profesor, de muy gran tamaño, para generar datos que servirán después para afinar el entrenamiento de otro modelo, llamado modelo alumno, mucho más pequeño. El modelo alumno puede así adquirir conocimientos similares a los de su profesor, necesitando muchos menos recursos para su ejecución [66].
Los modelos podados (Pruning)
La poda (pruning) consiste en eliminar parámetros del modelo. Esta técnica permite reducir en gran medida el tamaño, y por tanto el coste de ejecución, conservando un buen rendimiento [67].
Conclusión
Síntesis
Antes de reducir el impacto ambiental asociado a la IA generativa, es necesario comprender los factores que lo influyen. Se pueden agrupar en 3 categorías: el modelo, su alojamiento y los tokens.
Existen herramientas para medir el de los modelos abiertos con precisión y certeza. Los modelos propietarios más potentes, como los de OpenAI, Google o Anthropic, son cajas negras y no permiten establecer una medición cierta. Algunos organismos independientes desarrollan métodos de estimación basados en numerosas hipótesis no verificables, pero en las que se puede uno apoyar para obtener órdenes de magnitud.
La calculadora que he desarrollado en paralelo a este artículo permite al usuario final de un chatbot cuantificar la reducción de su impacto al poner en práctica buenas prácticas: Calculadora del impacto ambiental de mi conversación con la IA
A su nivel, las tres principales palancas que puede accionar de forma inmediata son:
- priorizar una búsqueda web clásica, desactivando las búsquedas automáticas por IA.
- elegir un modelo de pequeño tamaño con un esfuerzo bajo, adecuado a la tarea que se va a realizar
- controlar la cantidad de tokens procesados en input y generados en output.
Como desarrollador, el margen de actuación es más amplio y afecta a conceptos invisibles para el usuario final.
En todos los niveles, es posible reducir drásticamente el impacto ambiental asociado al uso de la IA, al tiempo que se mejora la calidad de las respuestas producidas.
Apertura
Este artículo es una síntesis de los conocimientos que he acumulado a lo largo de año y medio de investigación, así como de mi vigilancia informativa continua sobre el tema. Quiero agradecer muy especialmente a Boris RUF, que compartió conmigo sus conocimientos y sus competencias durante todo este período, mientras yo ejercía como Data Scientist en AXA Group Operations. También quiero agradecer a Céline LESCOP, que me brindó la oportunidad y las ganas de profundizar en el tema de lo digital responsable con el medio ambiente al permitirme participar en el programa Digital Sustainability.
Si desea profundizar en el tema, formar a sus equipos de negocio y de IT en las buenas prácticas, realizar un balance ambiental de sus herramientas existentes o diseñar nuevas herramientas, no dude en ponerse en contacto conmigo. Estaré encantado de intervenir en su organización para acompañarle en este proceso.
Por último, quedo abierto a sus comentarios, críticas constructivas y sugerencias de mejora, tanto sobre el contenido de este artículo como sobre la herramienta asociada.
Referencias
- Marianne Enault (2025). Intelligence artificielle : ce qu’il faut savoir sur son impact sur la planète. TF1 Info. Mis à jour le 10 février 2025. https://www.tf1info.fr/environnement-ecologie/sommet-intelligence-artificielle-paris-ce-qu-il-faut-savoir-sur-son-impact-sur-la-planete-2349018.html ↩
- IPCC (2021). Summary for Policymakers. Climate Change 2021: The Physical Science Basis, GIEC. https://report.ipcc.ch/ar6syr/headline.html ↩
- Leo XIV (2026). Magnifica Humanitas: Encyclical Letter of His Holiness Pope Leo XIV on Safeguarding the Human Person in the Time of Artificial Intelligence. The Holy See. https://www.vatican.va/content/leo-xiv/en/encyclicals/documents/20260515-magnifica-humanitas.html ↩
- International Energy Agency (2025). Energy and AI. International Energy Agency. https://iea.blob.core.windows.net/assets/de9dea13-b07d-42c5-a398-d1b3ae17d866/EnergyandAI.pdf ↩
- Miriam Aczel, Sanaz Chamanara, Mir Matin, Aria Farsi, Tshilidzi Marwala, Kaveh Madani (2026). Environmental Cost of AI's Energy Use: Carbon, Water and Land Footprints. United Nations University Institute for Water, Environment and Health (UNU-INWEH). https://doi.org/10.53328/INR26RMA002 ↩ ↩
- OpenAI (2026). Tokenizer. https://platform.openai.com/tokenizer ↩
- Francisco Caravaca (2026). Measuring Energy Consumption of LLMs Inferences. ACM SIGMETRICS Performance Evaluation Review. https://doi.org/10.1145/3788882.3788890 ↩ ↩
- Tina Vartziotis, Rodopi Kosteli, Elli Vartziotis, George Dasoulas, Michael Keckeisen, Konstantinos Skianis, Sotirios Kotsopoulos, Francesca Dominici (2026). From Tokens to Watt-hours: Analytical Energy Estimation for LLM Inference on Modern GPUs. https://arxiv.org/abs/2607.26571 ↩ ↩
- Lola Solovyeva, Fernando Castor (2026). Towards Green AI: Decoding the Energy of LLM Inference in Software Development. ArXiv.org. ↩
- Boris Ruf, Marcin Detyniecki (2026). The Cost of Context: Profiling the Energy Footprint of Input Tokens in Large Language Models. ACM SIGENERGY Energy Informatics Review. https://hotcarbon.org/assets/2026/paper-17.pdf ↩ ↩
- Maximilian Dauner, Gudrun Socher (2025). Energy costs of communicating with AI. Frontiers in Communication. https://www.frontiersin.org/journals/communication/articles/10.3389/fcomm.2025.1572947 ↩
- Jon Saad-Falcon, Avanika Narayan, Hakki Orhun Akengin, J. Wes Griffin, Herumb Shandilya, Adrian Gamarra Lafuente, Medhya Goel, Rebecca Joseph, Shlok Natarajan, Etash Kumar Guha, Shang Zhu, Ben Athiwaratkun, John Hennessy, Azalia Mirhoseini, Christopher Ré (2026). Intelligence per Watt: Measuring Intelligence Efficiency of Local AI. https://arxiv.org/abs/2511.07885 ↩
- International Energy Agency (2025). Emissions Factors 2025. Licence: Terms of Use for Non-CC Material. https://www.iea.org/data-and-statistics/data-product/emissions-factors-2025 ↩
- ADEME (2013). Base Empreinte® — Découverte. https://base-empreinte.ademe.fr/aide/decouverte ↩
- Ember (2026). Yearly Electricity Data. https://ember-energy.org/data/yearly-electricity-data/ ↩
- Willie Jones (2008). How Much Water Does It Take to Make Electricity? IEEE Spectrum. https://spectrum.ieee.org/how-much-water-does-it-take-to-make-electricity ↩
- Jessica Le Goff (2023). Comment réduire la consommation d’eau des systèmes de refroidissement des data centers. https://www.apl-datacenter.com/fr/ressources/avis-experts/reduire-consommation-eau-des-systemes-de-refroidissement-data-centers/ ↩
- Michael Patterson, Dan Azevedo, Christian Belady, Jack Pouchet (2011). WP\#35 - Water Usage Effectiveness (WUE): A Green Grid Data Center Sustainability Metric. https://archive.thegreengrid.org/en/resources/library-and-tools/238-WP\#35---Water-Usage-Effectiveness-(WUE):-A-Green-Grid-Data-Center-Sustainability-Metric- ↩
- Christopher Malone, Christian L. Belady (2006). Metrics to Characterize Data Center & IT Equipment Energy Use. Proceedings of the Digital Power Forum. https://www.researchgate.net/publication/337801067_Metrics_to_Characterize_Data_Center_IT_Equipment_Energy_Use_Proceedings_of_Digital_Power_Forum_Richardson_TX ↩
- Petroc Taylor (2026). Data Center Average Annual Power Usage Effectiveness (PUE) Worldwide from 2007 to 2025. https://www.statista.com/statistics/1229367/data-center-average-annual-pue-worldwide/ ↩
- Google Data Centers (2026). Power usage effectiveness. https://datacenters.google/efficiency/ ↩
- Mistral AI (2025). Our contribution to a global environmental standard for AI. https://mistral.ai/news/our-contribution-to-a-global-environmental-standard-for-ai/ ↩ ↩
- Johannes Zschache, Tilman Hartwig (2026). Comparing energy consumption and accuracy in text classification inference. Scientific Reports. https://doi.org/10.1038/s41598-026-45023-0 ↩ ↩
- Bojie Li (2026). Incompressible Knowledge Probes: Estimating Black-Box LLM Parameter Counts via Factual Capacity. https://arxiv.org/abs/2604.24827 ↩ ↩
- Mingdeng Du (2026). Tiered Super-Moore's Law: Price Evolution, Production Frontiers, and Market Competition in Large Language Model Inference Services. https://arxiv.org/abs/2603.28576 ↩
- Siyuan Mu, Sen Lin (2026). A Comprehensive Survey of Mixture-of-Experts: Algorithms, Theory, and Applications. https://arxiv.org/abs/2503.07137 ↩
- Chenxu Niu, Wei Zhang, Yongjian Zhao, Yong Chen (2025). Energy Efficient or Exhaustive? Benchmarking Power Consumption of LLM Inference Engines. ACM SIGEnergy Energy Informatics Review. https://doi.org/10.1145/3757892.3757900 ↩
- NVIDIA Corporation (2026). LLM Inference Quick Start Recipes. https://docs.nvidia.com/llm-inference-quick-start-recipes/overview ↩ ↩
- Jae-Won Chung, Jeff J. Ma, Ruofan Wu, Jiachen Liu, Oh Jun Kweon, Yuxuan Xia, Zhiyu Wu, Mosharaf Chowdhury (2025). The ML.ENERGY Benchmark: Toward Automated Inference Energy Measurement and Optimization. https://arxiv.org/abs/2505.06371 ↩ ↩
- Jie You, Jae-Won Chung, Mosharaf Chowdhury (2023). Zeus: Understanding and Optimizing GPU Energy Consumption of DNN Training. USENIX NSDI, University of Michigan. ↩ ↩
- OpenAI Academy (2026). Environmental Impact of AI. Consulté le 16 août 2026. https://academy.openai.com/public/clubs/higher-education-05x4z/resources/environmental-impact-of-ai ↩
- Cooper Elsworth, Keguo Huang, David Patterson, Ian Schneider, Robert Sedivy, Savannah Goodman, Ben Townsend, Parthasarathy Ranganathan, Jeff Dean, Amin Vahdat, Ben Gomes, James Manyika (2025). Measuring the environmental impact of delivering AI at Google Scale. https://arxiv.org/abs/2508.15734 ↩
- Sam Altman (2025). The Gentle Singularity. https://blog.samaltman.com/the-gentle-singularity ↩
- Sasha Luccioni, Yacine Jernite, Emma Strubell (2024). Power Hungry Processing: Watts Driving the Cost of AI Deployment? The 2024 ACM Conference on Fairness Accountability and Transparency, ACM. http://dx.doi.org/10.1145/3630106.3658542 ↩
- Epoch AI (2026). How Much Energy Does ChatGPT Use? Epoch AI. Consulté le 16 août 2026. https://epoch.ai/gradient-updates/how-much-energy-does-chatgpt-use ↩
- Nidhal Jegham, Marwan Abdelatti, Chan Young Koh, Lassad Elmoubarki, Abdeltawab Hendawi (2025). How Hungry is AI? Benchmarking Energy, Water, and Carbon Footprint of LLM Inference. https://arxiv.org/abs/2505.09598 ↩
- Samuel Rincé, Adrien Banse (2025). EcoLogits: Evaluating the Environmental Impacts of Generative AI. Journal of Open Source Software. https://joss.theoj.org/papers/10.21105/joss.07471.pdf ↩
- SNCFdevelopers (2026). Impact'IA: LLM Environmental Footprint Calculator. Calculatrice d'impact environnemental des modèles de langage et guide méthodologique. https://github.com/SNCFdevelopers/ImpactIA ↩ ↩
- Hugging Face (2026). LLM Perf Leaderboard. https://huggingface.co/spaces/optimum/llm-perf-leaderboard ↩ ↩
- Alex de Vries (2023). The growing energy footprint of artificial intelligence. Joule. https://www.sciencedirect.com/science/article/pii/S2542435123003653 ↩
- Tianqi Xiao, Francesco Fuso Nerini, H. Damon Matthews, Massimo Tavoni, Fengqi You (2025). Environmental impact and net-zero pathways for sustainable artificial intelligence servers in the USA. Nature Sustainability. https://doi.org/10.1038/s41893-025-01681-y ↩
- Jeffrey Dastin, Stephen Nellis (2023). Focus: For tech giants, AI like Bing and Bard poses billion-dollar search problem. Reuters. ↩
- Boris Ruf, Marcin Detyniecki (2023). Open and Linked Data Model for Carbon Footprint Scenarios. https://arxiv.org/abs/2310.01278 ↩
- Benoît Courty, Victor Schmidt, Goyal-Kamal, inimaz, MarionCoutarel, Luis Blanche, Boris Feld, Amine Saboni, Jérémy Lecourt, LiamConnell, David Berenstein, Patrick LLORET, SabAmine, supatomic, cianc, Mathilde Léval, Alexis Cruveiller, ouminasara, Franklin Zhao, rosekelly6400 (2026). mlco2/codecarbon: v3.3.0. Zenodo. Version 3.3.0. https://doi.org/10.5281/zenodo.21791294 ↩
- Samuel Rincé, Adrien Banse, Valentin Defour, Caroline Jean-Pierre (2025). EcoLogits Calculator. https://calculator.ecologits.ai/ ↩
- Samuel Rincé (2022). Awesome Green AI. Dépôt GitHub, consulté le 9 octobre 2026. https://github.com/samuelrince/awesome-green-ai ↩
- Urs Hölzle (2009). Powering a Google search. https://googleblog.blogspot.com/2009/01/powering-google-search.html ↩
- Wim Vanderbauwhede (2025). Estimating the Increase in Emissions caused by AI-augmented Search. https://arxiv.org/abs/2407.16894 ↩
- Lingjiao Chen, Matei Zaharia, James Zou (2023). FrugalGPT: How to Use Large Language Models While Reducing Cost and Improving Performance. https://arxiv.org/abs/2305.05176 ↩
- Jinghan Cao, Yu Ma, Xinjin Li, Qingyang Ren, Xiangyun Chen (2026). Task-Specific Efficiency Analysis: When Small Language Models Outperform Large Language Models. https://arxiv.org/abs/2603.21389 ↩ ↩
- OpenAI (2026). Improving GPT-5.6 Sol in ChatGPT---and expanding access to GPT-5.6 Luna for free users. https://openai.com/index/improving-gpt-5-6-sol-in-chatgpt/ ↩
- Anthropic (2025). Best practices for prompt engineering for 2026. https://claude.com/blog/best-practices-for-prompt-engineering ↩
- Yuyang Wu, Yifei Wang, Ziyu Ye, Tianqi Du, Stefanie Jegelka, Yisen Wang (2025). When More is Less: Understanding Chain-of-Thought Length in LLMs. https://arxiv.org/abs/2502.07266 ↩
- OpenAI (2026). Prompt engineering. https://developers.openai.com/api/docs/guides/prompt-engineering ↩
- Marta Adamska, Daria Smirnova, Hamid Nasiri, Zhengxin Yu, Peter Garraghan (2026). Green Prompting: Characterizing Prompt-driven Energy Costs of LLM Inference. https://arxiv.org/abs/2503.10666 ↩
- Boris Ruf, Marcin Detyniecki (2025). Mitigating the Carbon Footprint of Chatbots as Consumers. Trends in Sustainable Computing and Machine Intelligence, Springer Nature Singapore. http://dx.doi.org/10.1007/978-981-96-1452-3_2 ↩
- Shardul Mane (2026). What Is Context Engineering? https://supermemory.ai/blog/what-is-context-engineering-complete-guide/ ↩
- OpenAI (2024). Mémoire et nouveaux contrôles pour ChatGPT. https://openai.com/fr-FR/index/memory-and-new-controls-for-chatgpt/ ↩
- Beibin Li, Yi Zhang, Sébastien Bubeck, Jeevan Pathuri, Ishai Menache (2024). Small Language Models for Application Interactions: A Case Study. https://arxiv.org/abs/2405.20347 ↩
- Soham Poddar, Paramita Koley, Janardan Misra, Sanjay Podder, Niloy Ganguly, Saptarshi Ghosh (2025). Towards Sustainable NLP: Insights from Benchmarking Inference Energy in Large Language Models. https://arxiv.org/abs/2502.05610 ↩ ↩
- M David, E Tom, B Paul (2025). Major large language models (LLMs): ranked by capabilities, sized by billion parameters used for training. https://informationisbeautiful.net/visualizations/the-rise-of-generative-ai-large-language-models-llms-like-chatgpt ↩
- Boris Ruf, Marcin Detyniecki (2026). Energy Consumption Analysis of Discrete Diffusion and Autoregressive Language Models. Proceedings of the 2nd International Workshop on Systems and Methods for Sustainable Large-Scale AI (GreenSys), Association for Computing Machinery. https://doi.org/10.1145/3802973.3804458 ↩
- William Stanley Jevons (1865). The Coal Question: An Inquiry Concerning the Progress of the Nation, and the Probable Exhaustion of Our Coal-Mines. Macmillan and Co. ↩
- Julien Delavande, Regis Pierrard, Sasha Luccioni (2026). Understanding Efficiency: Quantization, Batching, and Serving Strategies in LLM Energy Use. https://arxiv.org/abs/2601.22362 ↩
- Scott Young (2025). DeepSeek, ChatGPT, and the global fight for technological supremacy. https://hls.harvard.edu/today/deepseek-chatgpt-and-the-global-fight-for-technological-supremacy/ ↩
- Xiaoqi Jiao, Yichun Yin, Lifeng Shang, Xin Jiang, Xiao Chen, Linlin Li, Fang Wang, Qun Liu (2020). TinyBERT: Distilling BERT for Natural Language Understanding. Findings of the Association for Computational Linguistics: EMNLP 2020, Association for Computational Linguistics. https://aclanthology.org/2020.findings-emnlp.372/ ↩
- Mengzhou Xia, Tianyu Gao, Zhiyuan Zeng, Danqi Chen (2024). Sheared LLaMA: Accelerating Language Model Pre-training via Structured Pruning. International Conference on Learning Representations. https://proceedings.iclr.cc/paper_files/paper/2024/file/160adf2dc118a920e7858484b92a37d8-Paper-Conference.pdf ↩