L'impact environnemental de l'IA générative : comment le réduire peut vous faire gagner en efficacité ?
Citer
@misc{mortas2026impact,
  author = {MORTAS, Félix},
  title = {L'impact environnemental de l'IA générative : comment le réduire peut vous faire gagner en efficacité ?},
  year = {2026},
  url = {https://felixmortas.com/ai-env-impact-knowledge/fr/},
  note = {Consulté en ligne ; dernière modification : 15 octobre 2026}
}On entend souvent qu’une requête ChatGPT consomme six fois plus d’électricité qu’une recherche Google, et qu’il faut environ un demi-litre d’eau pour générer 10 à 50 réponses [1].
Mais ces chiffres reflètent-ils vraiment la réalité ?
Pas si vite ! Derrière ces affirmations se cachent des approximations et des raccourcis méthodologiques qui méritent d’être examinés de plus près.
La calculatrice conçue pour illustrer cet article estime que ce simple message envoyé à DeepSeek a émis 0,28 g de CO₂ équivalent (gCO₂e) et consommé 0,06 mL d’eau. C'est l'équivalent d'une ampoule allumée pendant 6 minutes, et d'1 goutte d'eau.
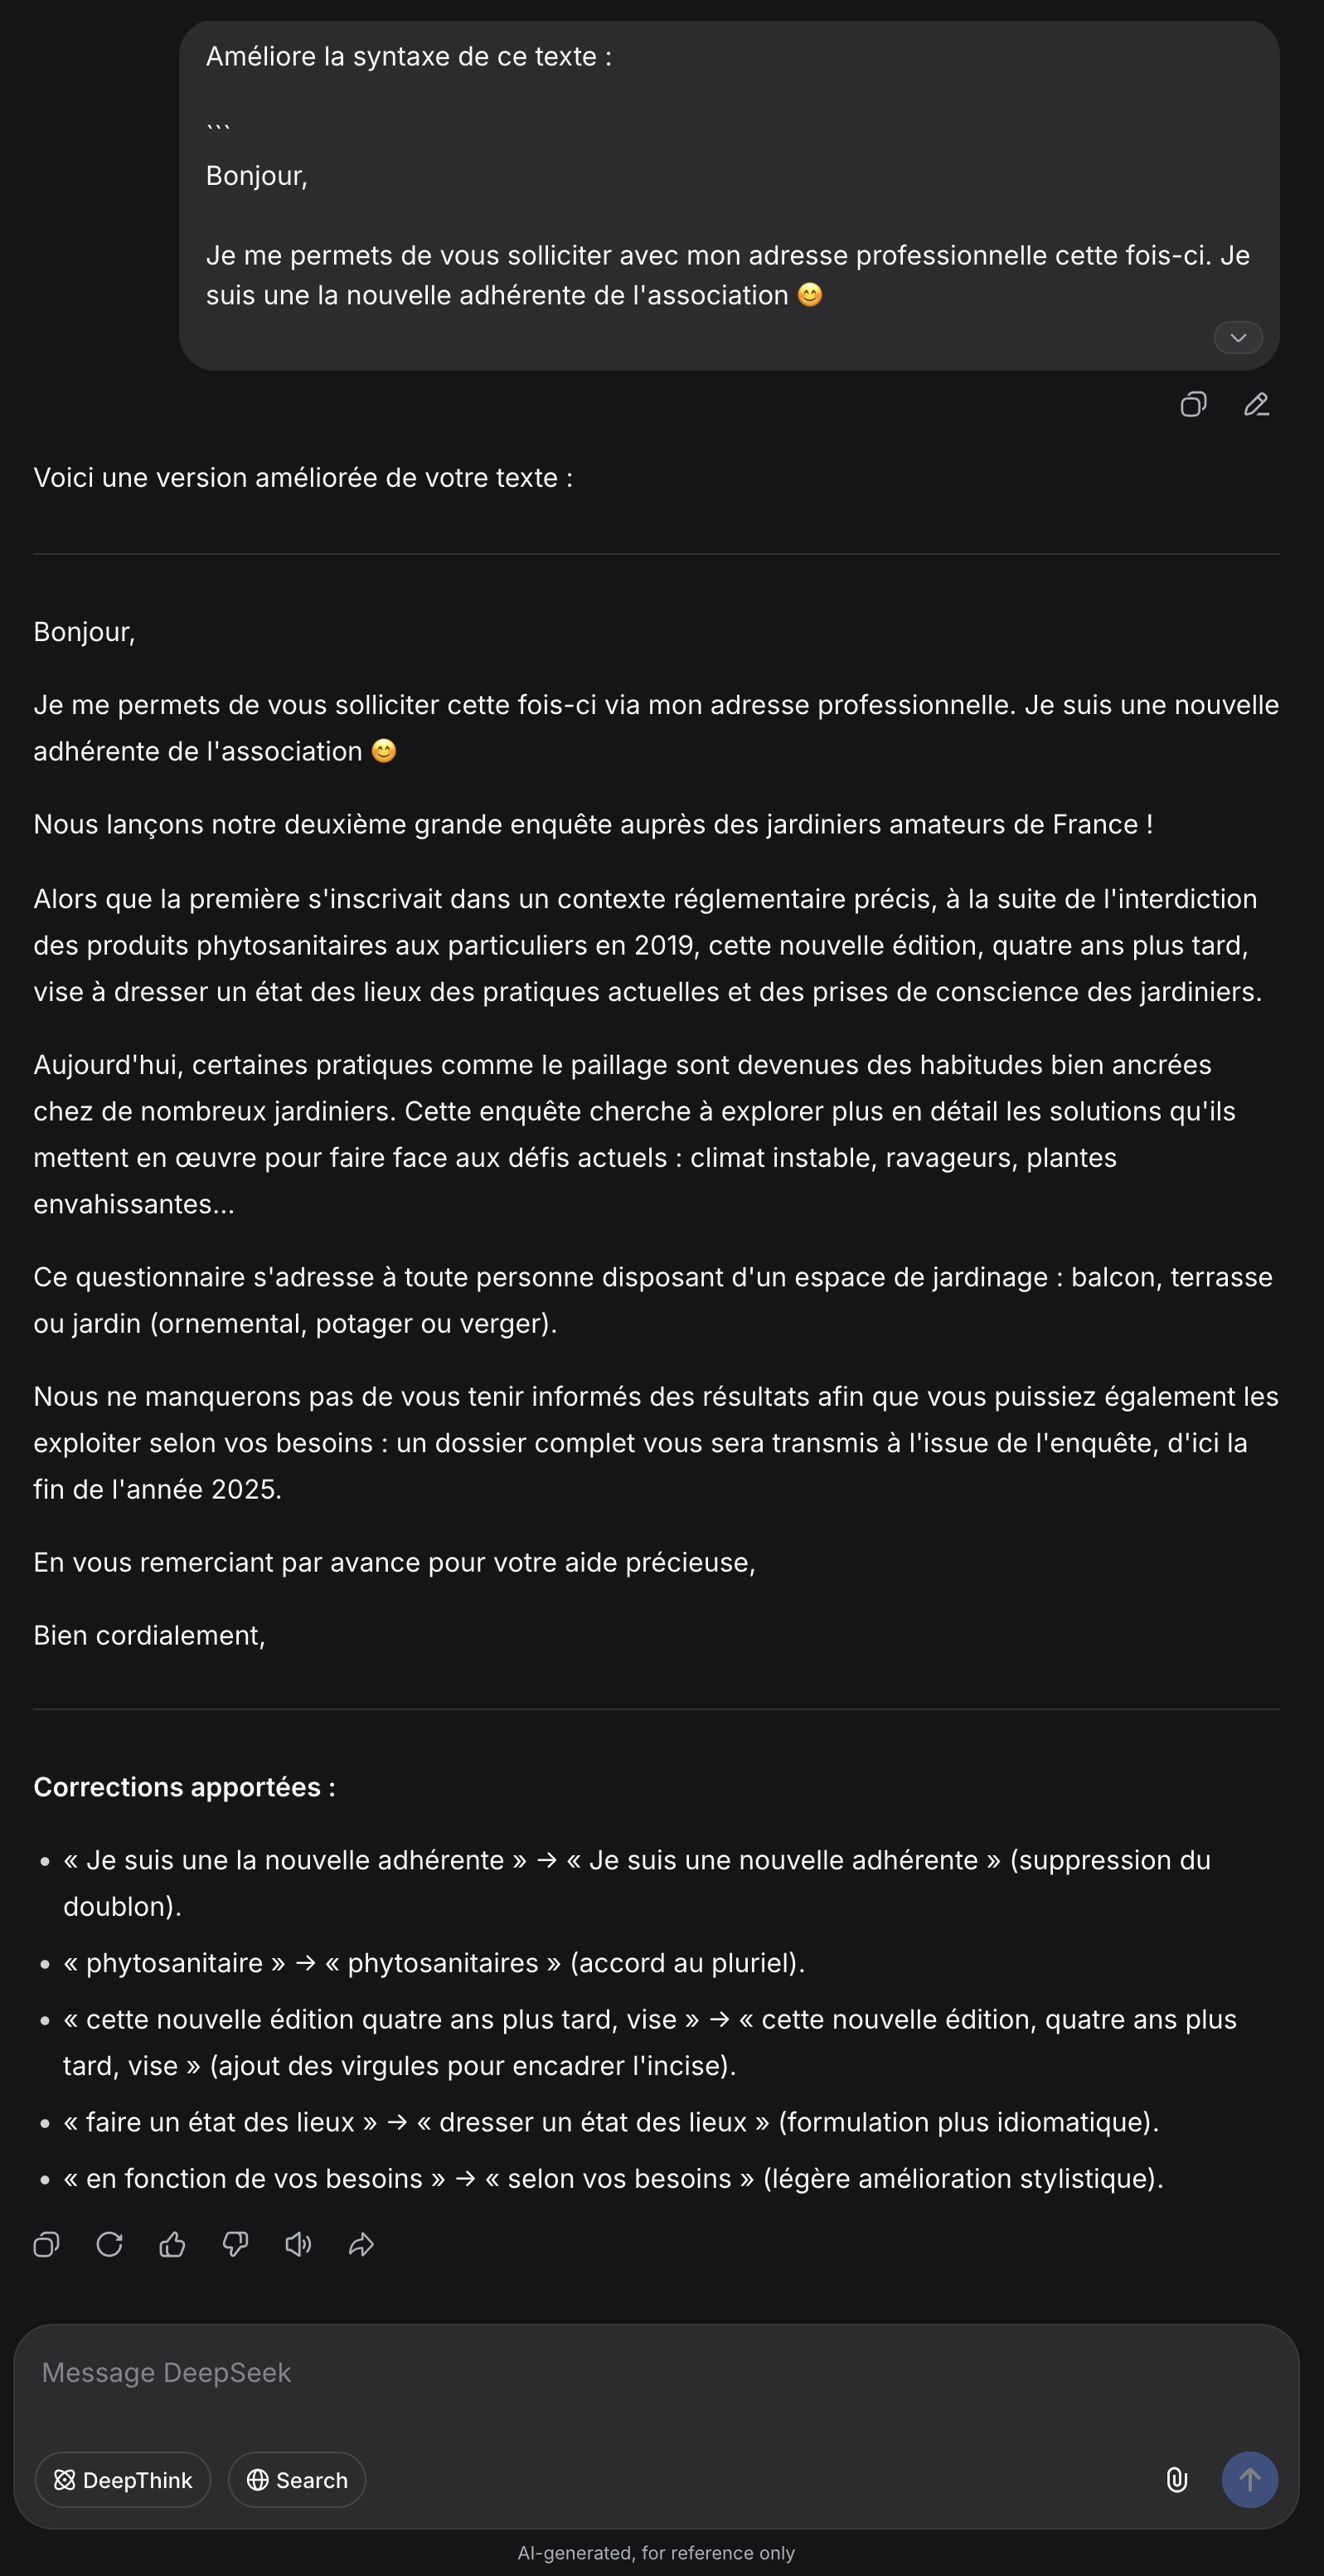
Pourtant, la calculatrice estime que cet échange bien plus complexe avec Claude a lui émis 7,48 gCO₂e et consommé 2 mL d’eau. C'est l'équivalent d'une ampoule allumée pendant 3 heures et 53 minutes, et de 40 gouttes d'eau.
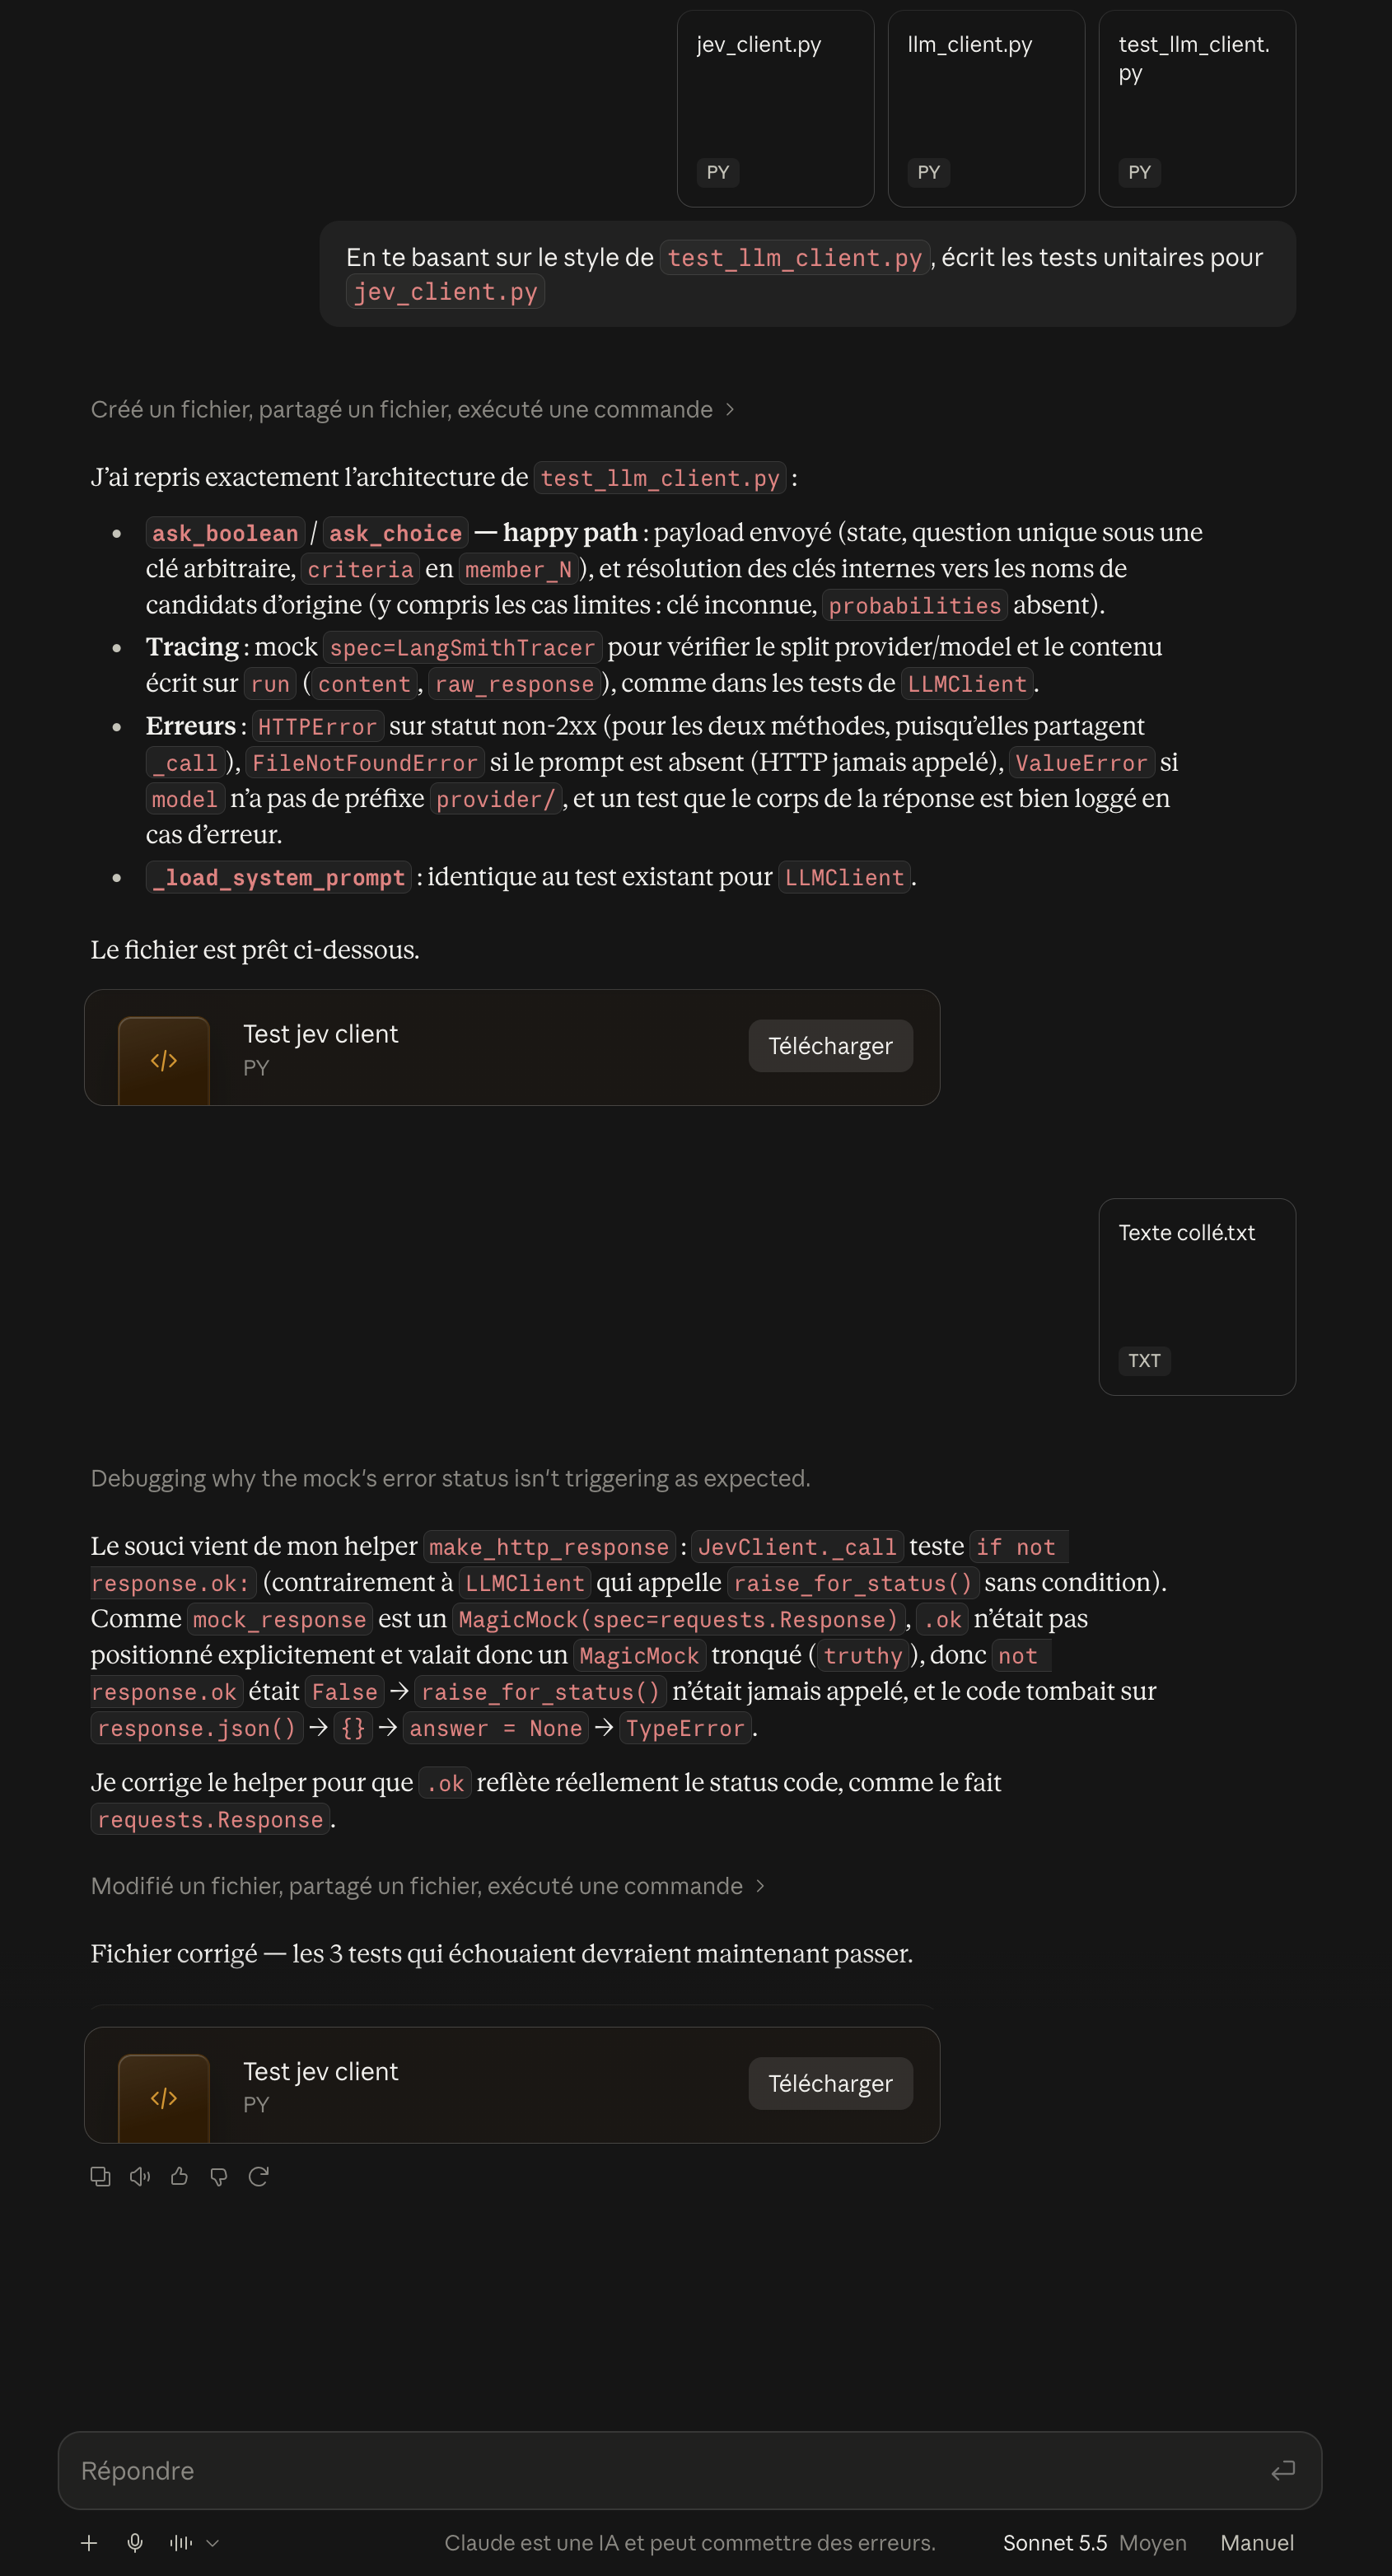
Les estimations prennent en compte le texte visible du chatbot, l'électricité utilisée pour faire fonctionner l'IA, et l'eau pour refroidir le data center. Elles ne prennent pas en compte le raisonnement de l'IA, les boucles d'action, l'entraînement du modèle, la fabrication du matériel informatique et du data center, l'utilisation du réseau, l'eau consommée pour produire l'électricité. L'impact environnemental global est donc largement sous-estimé.
Mais comment expliquer une telle différence ?
Dans cet article, nous allons décrypter ce qui se cache derrière ces chiffres et comprendre ce qui fait réellement varier l’empreinte environnementale de nos conversations avec l’IA. Vous allez également vous rendre compte qu'adopter de bonnes pratiques environnementales conduit généralement à une utilisation plus efficace.
Introduction
Dans un contexte de changement climatique lié aux activités humaines [2], même le pape s'inquiète des risques engendrés par l'IA [3].
Le rapport « Energy and AI » publié par l’IEA en avril 2025 prévoit que la demande mondiale en énergie pour les centres de données va doubler et passer à environ 945 TWh d’ici 2030 — soit un niveau comparable à la consommation annuelle d’électricité du Japon —, et qui devrait atteindre environ 1 200 TWh d’ici 2035 [4]. Les Nations Unies ont récemment publié un rapport sur l'impact environnemental de l'IA au niveau des émissions carbone et de la consommation d'eau [5].
Les organisations ainsi que les particuliers doivent contrôler leur empreinte environnementale. Des conseils concrets et réels pour la réduction de cet impact sont nécessaires au niveau des utilisateurs et des développeurs. Mais pour agir de manière efficace, il faut premièrement comprendre certains aspects du fonctionnement de l'IA.
J'ai réalisé des travaux de recherche sur l'impact environnemental de l'IA générative pendant 18 mois chez AXA, ce qui m'a permis d'accumuler de nombreuses connaissances sur le sujet que je souhaite aujourd'hui partager avec vous.
À travers cet article, vous comprendrez quels sont les facteurs qui influencent le plus l'impact environnemental de l'IA, comment le mesurer lorsque c'est possible, et comment le réduire en tant qu'utilisateur final et développeur.
Vous découvrirez également ce calculateur vous permettant de mesurer l'impact d'une de vos conversations avec un chatbot (ChatGPT, Claude, Gemini, mais aussi Mistral, DeepSeek, etc.). Vous pourrez également simuler l'application de certaines bonnes pratiques sur cette même conversation, et ainsi vous rendre compte de la pertinence de celles-ci.
Ce calculateur n'a pas pour objectif de concurrencer les méthodes d'estimation existantes, ni de fournir une mesure certaine. Il a pour objectif d'illustrer l'efficacité des bonnes pratiques présentées dans cet article.
Facteurs influençant l'impact environnemental de l'IA générative
Les principaux impacts environnementaux liés à l'utilisation de l'IA que nous étudierons dans cet article sont les suivants :
- Les émissions de gaz à effet de serre (GES) liées à l'électricité et aux autres sources d'énergie nécessaires au fonctionnement des data centers qui font fonctionner les modèles d'IA ;
- La consommation d'eau pour refroidir les équipements informatiques des data centers.
D'autres impacts pourraient être pris en compte mais comme le sujet manque encore un peu de maturité, nous nous limiterons à ces deux là.
Les fondamentaux : le Large Language Model (LLM)
Dans un chatbot comme ChatGPT, un mécanisme permet de générer des réponses qui donnent l'impression d'une véritable conversation. C'est le LLM : Large Language Model. Il s'agit d'un modèle d'intelligence artificielle générative, entraîné sur une très grande quantité de textes afin d'apprendre les caractéristiques et les relations entre les mots et les phrases. Son objectif principal est de prédire, à partir du contexte fourni, quels mots sont les plus susceptibles de venir ensuite.
Les tokens
Les LLM ne traitent pas directement des mots, mais des tokens. Un embedder (outil de transformation) décompose les mots en tokens avant le traitement. Une règle empirique utile consiste à considérer qu'un token correspond généralement à environ 4 caractères dans un texte anglais courant. Cela équivaut à environ les trois quarts d'un mot (ainsi, 100 tokens correspondent à environ 75 mots) [6].
Exemple de découpage : « Impacting the environment » se décompose en 4 tokens : « Impact / ing / the / environment »
Les concepteurs de LLM utilisent des embedders différents, ce qui signifie qu'un même texte peut produire un nombre de tokens variable selon le modèle.
Les tokens peuvent se diviser en deux catégories :
- les tokens d'entrée (aussi appelés : tokens d'input, d'instruction, de l'utilisateur ou envoyés)
- les tokens de sortie (aussi appelés : tokens d'output, générés, de l'assistant ou reçus).
Plus l'IA doit traiter de tokens, plus elle consomme d'énergie
Le nombre de tokens de sortie est théoriquement proportionnel à la consommation d'énergie totale.
Exemple : Un échange qui nécessite de traiter 10 tokens consomme deux fois moins d'énergie qu'une requête qui traite 20 tokens.
Les tokens de sortie consomment généralement plus d'énergie que les tokens d'entrée
Certaines études montrent que le traitement d'un échange avec un long message envoyé (par exemple, 50 000 tokens) ne consomme que très légèrement plus d'énergie que de courts messages envoyés [7]. Cela laisse supposer que la consommation d'un token d'entrée est négligeable par rapport à un token de sortie. En réalité, sa consommation varie fortement en fonction de la longueur totale du message. Elle peut être plus faible lorsque le message est court, mais plus importante lorsque le message est long. C'est la même chose pour les tokens de sortie [8] [9].
Modèle simplifié : Une requête avec 1000 tokens en entrée et 50 tokens en sortie consommera en théorie moins d'énergie qu'une requête avec 50 tokens en entrée et 1000 tokens en sortie.
En supposant que la plupart des échanges avec un chatbot sont longs, on ne peut pas considérer que la consommation d'un token d'entrée est négligeable [10].
Règle générale : moins une requête traite de tokens en sortie, moins elle consommera d'énergie. C'est pareil pour les tokens en entrée, mais en général de manière moins prononcée que pour les tokens de sortie.
Les tokens de raisonnement s'ajoutent aux tokens de sortie
Un modèle de raisonnement produit d'abord un texte de planification sur lequel il s'appuie pour élaborer sa réponse finale. Les tokens générés par le modèle de raisonnement sont parfois non visibles pour l'utilisateur. Un token de raisonnement consomme autant d'énergie qu'un token de sortie. Ils augmentent le nombre total de tokens traités par le LLM, et donc sa consommation énergétique [11].
Ainsi, nous comprenons que le nombre de tokens traités, en particulier les tokens de sortie, a un fort impact sur l'impact environnemental. Pour mesurer cet impact et quantifier son empreinte énergétique, carbone et hydrique, trois indicateurs clés peuvent être suivis :
- les émissions de GES, exprimées en masse de dioxyde de carbone équivalent (gCO₂e) ;
- la consommation d'énergie, exprimée en watt-heures (Wh) ;
- la consommation d'eau, exprimée en volume (L ou m³).
Ces indicateurs s'appliquent aussi bien pour les tokens d'entrée que pour les tokens de sortie.
Le rôle majeur du centre de données
Une IA générative, comme un LLM, est un programme exécuté sur un ordinateur. Cela peut être votre machine personnelle, mais cela se fait généralement dans des centres de données (data centers). Son fonctionnement nécessite de l'énergie, ce qui engendre un impact environnemental, mesuré ici en gCO₂e/kWh.
Les différents services permettant d'utiliser un LLM, et consommant de l'énergie, sont les suivants :
- Hébergement dans un data center public (Microsoft Azure, Amazon Web Services, Google Cloud Platform) : l'IA est exécutée sur des serveurs dans un data center appartenant à une entreprise (cloud) plutôt que directement sur votre ordinateur. Ces serveurs sont très puissants et permettent d'exécuter des modèles d'IA que vous avez téléchargés ou que vous avez développés et entraînés vous-même. Dans ce cas, vous possédez l'IA et choisissez le fournisseur de cloud et la région géographique dans lesquels il sera exécuté.
- Hébergement dans votre propre data center : généralement réservé aux entreprises, le principe de fonctionnement est similaire au cloud public : vous détenez l'IA et décidez de la localisation de la machine sur laquelle la faire tourner.
- Dans les data centers des fournisseurs d'IA officiels comme OpenAI, Anthropic (Claude), Google, Mistral AI, Meta, DeepSeek, Z.ai, Moonshot AI ou d'agrégateurs comme OpenRouter, Vercel, Groq et MammouthAI. Ici, vous ne contrôlez rien sur le fonctionnement de l'IA. Elle peut être hébergée dans un data center privé, ou chez un fournisseur de cloud public (au nom du fournisseur ou de l'agrégateur).
- Sur votre ordinateur : certaines IA récentes et petites peuvent fonctionner directement sur votre ordinateur, tout en fournissant des performances compétitives avec les grands modèles propriétaires [12]. Vous maîtrisez alors 100 % de la consommation énergétique liée à son utilisation et pouvez utiliser l'IA générative hors connexion.
Le coût de la production d'électricité par pays
Chaque pays produit de l'électricité avec un impact environnemental variable. Pour générer 1 kWh, une centrale émet des GES et consomme de l'eau.
Certains organismes fournissent les facteurs d'émission de carbone de chaque pays (en gCO₂e/kWh produit) :
- l'International Energy Agency (IEA), normalement payant mais accessible gratuitement sur demande [13] ;
- l'ADEME, gratuit mais reprend les données de l'IEA de 2011 [14] ;
- Ember Energy, gratuit et reprend des données de 2025 de l'IEA, Eurostat, BP et UN [15] ;
- Spectrum IEEE, gratuit et par pays ou type de production [16].
D'après Ember Energy, ces facteurs peuvent aller d'un peu plus de 20 (Islande) à plus de 800 gCO₂e/kWh (Mongolie). La localisation des serveurs joue un rôle principal dans l'impact environnemental de l'IA.
Les data centers doivent être refroidis
Lors de l'utilisation des serveurs, l'électricité reçue est convertie en chaleur. Pour maintenir leur bon fonctionnement, les serveurs d'un data center doivent être maintenus à une température optimale. Afin d'évacuer la chaleur, les data centers utilisent différentes méthodes de refroidissement [17], notamment :
- Le refroidissement direct par air extérieur : Possible dans les régions au climat frais, cette méthode ventile l'air extérieur pour refroidir les serveurs. Elle consomme de l'électricité principalement pour alimenter les ventilateurs et ne consomme pas d'eau.
- Le refroidissement adiabatique : L'air chaud extérieur est ventilé et refroidi par pulvérisation de fines gouttelettes d'eau qui s'évaporent à son contact. Cette méthode consomme à la fois de l'électricité et de l'eau.
- Le refroidissement direct des puces (Direct Chip Cooling) : De l'eau circule dans des micro-tuyaux entre les composants des serveurs pour les refroidir directement. Bien que l'eau ne soit pas consommée, elle doit être refroidie à un moment donné dans le circuit, ce qui nécessite souvent de l'énergie. De plus, cette eau peut être mobilisée par le data center pendant des périodes de forte demande (par exemple, pour la consommation humaine ou l'arrosage agricole en été), ce qui peut poser des problèmes de concurrence d'usage.
La consommation d'eau peut être mesurée
Le WUE (Water Usage Effectiveness) est un indicateur mesurant la quantité d'eau consommée par les data centers [18]. Cette eau dite consommée est en réalité évaporée dans l'atmosphère. L'eau prélevée dans l'environnement et remise plus tard n'est pas prise en compte dans le calcul de cet indicateur.
Formule : WUE (L/kWh) = Eau consommée (L) / Énergie consommée par les serveurs (kWh)
Le WUE dépend principalement de la localisation du data center et de ses méthodes de refroidissement. Ceux qui se trouvent dans des régions arides ont un WUE généralement plus élevé, et mobilisent donc davantage d'eau lors des périodes de forte chaleur.
| WUE (L/kWh) | Source | Consommation d'eau annuelle (m³) | Équivalent (piscines olympiques) |
|---|---|---|---|
| 0,12 | Amazon | Inconnu | -- |
| 0,255 | Microsoft | 8 170 000 | 3 268 |
| 0,29 | OVH France Roubaix | Inconnu | -- |
| 0,19 | Meta Texas Fort Worth | 195 000 | 78 |
Source : Rapports environnementaux
Indice d'efficacité énergétique : le PUE
Un même serveur consomme la même quantité d'énergie, quelle que soit sa localisation. Cependant, l'énergie pour le maintenir à une température optimale varie en fonction du climat. Ainsi, il faut plus ou moins d'énergie pour le refroidir selon sa localisation.
L'indicateur permettant de mesurer l'efficacité énergétique d'un data center, notamment pour le refroidissement et la maintenance de l'infrastructure, est le PUE (Power Usage Effectiveness) [19]. Il représente le ratio entre :
- la consommation totale du data center ;
- la consommation liée uniquement à l'exécution des serveurs.
Formule : PUE = Consommation totale du data center (kWh) / Consommation des serveurs du data center (kWh)
Exemples d'interprétation :
- PUE = 1 : idéal. Toute l'énergie est utilisée uniquement pour faire fonctionner les serveurs.
- PUE > 1 : en plus de l'énergie pour faire fonctionner les serveurs, le data center en consomme également pour refroidir des serveurs.
- PUE = 2 : autant d'énergie est consommée pour alimenter les serveurs que pour les refroidir.
- PUE > 2 : très mauvais. Plus d'énergie est consommée pour refroidir les serveurs que pour les alimenter.
Le PUE moyen mondial est de 1,54 [20], quand celui de Google est de 1,09 [21].
Le PUE des data centers est un critère clé dans le choix d'un fournisseur cloud et de la région d'hébergement.
Le choix du modèle d'IA utilisé
La taille du modèle
On mesure la taille d'un modèle de langage par son nombre de paramètres. Plus un modèle compte de paramètres activés pendant son exécution, plus sa consommation énergétique pour un token est élevée. Cette consommation est directement proportionnelle au nombre de paramètres.
Exemple : un modèle avec 100 milliards de paramètres consomme deux fois moins d'électricité pour traiter un token qu'un modèle avec 200 milliards de paramètres [22].
Cette règle ne s'applique pas nécessairement à tous les fournisseurs de modèles. En effet, chacun utilise des méthodes de conception différentes, ce qui a un impact sur la consommation énergétique des modèles [23]. Cependant, elle peut généralement s'appliquer à tous ceux d'une même famille : les modèles GPT-6 entre eux, les modèles Gemini 3 entre eux, etc. Ainsi, même si cette règle n'est pas universelle pour comparer tous les modèles entre eux, elle reste un indicateur fiable pour orienter le choix d'un modèle chez un même fournisseur.
Transparence des fournisseurs : Les modèles open source affichent leur nombre de paramètres. Mais celui des modèles des fournisseurs privés comme OpenAI, Anthropic ou Google n'est jamais divulgué. Il est néanmoins possible de ranger par taille les modèles d'un même fournisseur grâce à leurs appellations : luna, lite, small, nano, mini < terra, flash, medium < sol, pro, large, plus, max. Certains travaux tentent de quantifier ce nombre de paramètres en se basant sur différentes méthodes innovantes, comme la comparaison du volume de connaissance stocké [24].
| Modèle | Vendeur | Params estimés |
|---|---|---|
| gpt-5.5 | OpenAI | 5 300 000 000 000 |
| claude-fable-5 | Anthropic | 3 500 000 000 000 |
| gemini-2.5-pro | 3 000 000 000 000 | |
| grok-4 | xAI | 2 000 000 000 000 |
| claude-sonnet-4.6 | Anthropic | 760 000 000 000 |
Source : https://01.me/research/ikp/#/calibration#proprietary
Il est également possible d'estimer la taille des modèles propriétaires en comparant leur prix à celui de modèles ouverts. Cependant cette méthode est très incertaine car la diminution du prix peut signifier une optimisation plutôt qu'une diminution du nombre de paramètres [25].
Les modèles MoE n'activent que les paramètres utiles
Un modèle MoE (Mixture of Experts) est un type de modèle qui n'utilise pas l'intégralité de ses paramètres lors de son exécution. Cela ne le rend pas moins performant ; au contraire, il active uniquement les paramètres nécessaires à la génération de la réponse. Par exemple, un modèle MoE de 300 milliards de paramètres peut n'en activer que 30 milliards, ce qui le rend beaucoup moins énergivore qu'un modèle dense de 100 milliards de paramètres [26]. En activant un faible nombre de paramètres, les modèles MoE diminuent la consommation énergétique pour le traitement d'un token.
Moteurs d'inférence
La consommation énergétique d'un LLM pendant l'exécution n'est pas uniquement déterminée par le modèle lui-même : elle dépend également du moteur d'inférence utilisé [27]. Un moteur d'inférence, c'est en quelque sorte le logiciel qui fait fonctionner un LLM au moment où on lui pose une question. Si le LLM était un moteur de voiture, le moteur d'inférence serait le système qui organise et contrôle son fonctionnement. Certains fournisseurs optimisent leurs modèles pour certains moteurs d'inférence [28].
Mesurer l'impact environnemental de l'IA générative
État de l'art
Aujourd'hui, des modèles d'IA sont mis à disposition de manière open-source ou open-weights (téléchargeables, mais dont le processus de conception est confidentiel) par des organismes privés comme Meta, Mistral, Google, DeepSeek ou Alibaba. Il est donc théoriquement possible de mesurer leur empreinte environnementale avec certitude.
Par exemple, le ML.ENERGY Leaderboard [29] mesure directement la consommation électrique des modèles à l'aide de son outil Zeus [30]. Cette initiative est même citée par OpenAI [31].
Cependant, les modèles les plus performants sont aujourd'hui détenus par OpenAI, Google et Anthropic. Ces modèles propriétaires sont principalement accessibles via des API qui empêchent la mesure directe de l'énergie par des organismes externes. Google estime qu'une requête médiane sur Gemini consomme 0,24 Wh d'énergie, émet 0,03 gCO₂e et consomme 0,26 mL (soit environ cinq gouttes) d'eau. L'impact énergétique par requête équivaut à regarder la télévision pendant moins de neuf secondes [32]. Le PDG d’OpenAI affirme qu’une requête moyenne adressée à ChatGPT consomme environ 0,34 Wh d’énergie et 0,3 mL (6 gouttes) d'eau [33]. Cependant, aucun des deux fournisseurs ne précise le nombre exact de tokens par prompt, ni le nombre de paramètres des modèles utilisés. Ce manque de transparence ne permet donc pas d'interpréter ces valeurs avec rigueur ni de comparer l’impact des modèles.
Certains acteurs tentent d'estimer l'impact environnemental des modèles fermés en recourant à des approximations [34]. Des analyses indépendantes estiment qu'une requête consomme entre 0,3 et 29 Wh [35] [36].
D'autres acteurs non lucratifs ont développé des méthodes d'estimation couvrant un large périmètre, basées sur des estimations pour les modèles fermés [37] [38] ou sur des données réelles mesurées sur des modèles ouverts [39].
Cependant, bien que le professionnalisme de ces organismes ne soit pas remis en cause, ces estimations doivent être interprétées avec prudence car elles reposent en grande partie sur des hypothèses difficilement vérifiables. Par exemple, une étude [40] citée 526 fois, notamment dans des articles de revues scientifiques sérieuses comme Nature [41], se base sur une citation d'un membre de la direction d'Alphabet (Google) sans preuve à l'appui [42].
Outils et calculateurs
Pour vous aider à tenter de mesurer l'impact environnemental de l'IA générative, des outils et calculateurs ont été développés :
Ma calculatrice de l'impact environnemental de votre conversation avec l'IA
Développée spécialement pour illustrer les bonnes pratiques partagées dans le prochain chapitre de cet article, cette calculatrice est conçue pour être simple d’utilisation et accessible au grand public. Elle est basée sur un périmètre restreint de la méthodologie d'Ecologits dans lequel certaines valeurs hypothétiques ont été remplacées par des valeurs mesurées. Des variables supplémentaires ont également été ajoutées afin de mettre en évidence les leviers permettant de réduire l’empreinte environnementale de l'utilisateur.
Testez-la dès maintenant en copiant-collant quelques extraits de votre dernière conversation avec une IA : https://felixmortas.com/ai-inf-calculator
Cette calculatrice, comme toute méthode d’estimation, présente des limites :
- Elle ne prend pas en compte les tokens de raisonnement invisibles. Une prochaine version pourrait estimer leur proportion par rapport au nombre de tokens de sortie visibles, en fonction du niveau d’effort de raisonnement.
- Les agents conversationnels effectuent probablement plusieurs passes de traitement, notamment lors de boucles. Le texte d’entrée peut donc être traité plusieurs fois. La calculatrice ne prend pas en compte ces boucles ni le retraitement des tokens qu’elles impliquent.
- Le coût énergétique d'un token de sortie dépend du nombre de tokens générés précédemment. Dans la calculatrice, on suppose que tous les tokens de sortie ont le même coût énergétique [8].
D'autres bons outils
- Zeus Project par ML.ENERGY : pour mesurer directement l'énergie consommée sur la machine [30], et le ML.ENERGY Leaderboard pour comparer la consommation énergétique des modèles ouverts [29].
- Un modèle de données ouvertes et interconnectées pour construire des scénarios d'empreinte carbone, améliorant la qualité et la transparence des données dès la conception [43].
- CodeCarbon : une bibliothèque Python pour mesurer en direct la consommation énergétique de la machine (ordinateur personnel ou serveur) [44]. Attention, car elle ne prend pas en compte le code exécuté à travers des API.
- EcoLogits par CodeCarbon : un calculateur web et une bibliothèque Python pour estimer l'empreinte carbone de l'IA générative à travers les API, en utilisant le token comme unité de mesure [45]. L'outil synergise bien avec CodeCarbon.
- Impact'IA par la SNCF : un calculateur avec un périmètre plus large qu'Ecologits, mais avec de nombreuses hypothèses qui augmentent considérablement l’incertitude [38].
- LLM Perf Leaderboard par Hugging Face : un comparateur des performances de modèles ouverts, incluant l'énergie par token généré [39].
- D'autres ressources comme des outils ou articles sont regroupés sur le dépôt GitHub [46] d'un membre de l'organisation CodeCarbon : https://github.com/samuelrince/awesome-green-ai
- Parfois, il est impossible de mesurer directement la consommation énergétique des machines. Cependant, celle-ci est très liée au temps d'exécution du modèle [23], ce qui en fait un paramètre utilisable pour mesurer l'impact environnemental d'un LLM hébergé.
Réduire son impact environnemental en mettant en place des bonnes pratiques
Dans ce chapitre, vous allez découvrir quelles sont les bonnes pratiques à mettre en place pour réduire votre impact environnemental lié à l'IA, et pourquoi les appliquer peut même améliorer votre efficacité.
Il existe des bonnes pratiques adaptées à deux catégories de public :
- L'utilisateur final : elles concernent la manière dont l'application IA est utilisée.
- Le développeur d'IA : elles influencent la manière dont l'application IA fonctionne.
Dans les deux cas, ces bonnes pratiques visent à minimiser votre empreinte écologique tout en optimisant vos performances.
Certains acteurs comme l'ONU proposent également des leviers de réduction qui seront présentés dans ce chapitre [5].
En tant qu'utilisateur d'un chatbot
Prioriser une recherche sur un moteur de recherche
Si la réponse attendue à votre question est simple (par exemple, le nombre d'habitants d'une ville ou la famille d'une plante), privilégiez une recherche sur un moteur de recherche (Google, Ecosia, Bing, Qwant, Brave, DuckDuckGo).
Si vous avez le réflexe de formuler votre question dans votre chatbot avec des mots-clés pour gagner du temps, sachez que vous pouvez directement saisir ces mots-clés dans votre moteur de recherche. La réponse sera tout aussi rapide et accessible via plusieurs sources. Exemples : « Plus grande planète système solaire », « vitesse de la lumière ».
Google estime qu'une recherche moyenne sur son moteur de recherche consomme 0,3 Wh d'énergie et émet 0,2 gCO₂e en 2009 [47], mais cette valeur n'est certainement plus valable. Une étude récente estime les nouvelles valeurs à 0,03 Wh et 0,02 gCO₂e, soit 10x moins que précédemment [48]. Pour comparer, Mistral AI estime qu'une requête adressée à leur modèle Mistral Large 2 avec 400 tokens en sortie émet 1,14 gCO₂e [22].
Attention : Dans vos recherches avec Google ou d'autres moteurs, la fonctionnalité de recherche par IA automatique (AI Overview) est activée par défaut. Vous devez la désactiver dans les paramètres pour que cette bonne pratique soit valable et choisir vous-même quand utiliser l'IA pour vos recherches.
Utiliser un modèle avec peu de paramètres activés
Lors de l'utilisation d'un chatbot, privilégiez le plus petit modèle, avec le moins de paramètres activés. Il est suffisant pour réaliser de nombreuses tâches avec précision [49] [50].
La plupart des fournisseurs d'IA ne communiquent ni le nom exact du modèle utilisé, ni le nombre de paramètres qu'il contient. Cependant, pour vous guider, sachez que les modèles portant des noms comme « flash », « lite », « rapide », « nano », « mini », « quick » ou « small » sont généralement ceux qui activent le moins de paramètres par token traité.
Recommandations pour choisir son modèle en fonction de la tâche à réaliser :
- Petit : approfondir un sujet, reformuler ou résumer un texte, générer un bout de code basique, classifier, extraire du texte.
- Intermédiaire : planifier, concevoir une architecture, générer du code dans un projet, réaliser un traitement non standardisé.
- Grand : résoudre un problème complexe en mathématiques, sciences ou ingénierie, concevoir une architecture complexe, réaliser une planification complexe, analyser des dossiers volumineux avec des sources contradictoires.
Vous l'aurez compris : les grands modèles sont surdimensionnés pour beaucoup de cas d'usage.
Avec les modèles GPT-5 sur ChatGPT, vous ne pouvez pas choisir manuellement le modèle utilisé. Un premier modèle, appelé « routeur », détermine automatiquement la taille du modèle qui traitera votre message. Pour les utilisateurs gratuits, toutes les requêtes sont envoyées au plus petit modèle [51].
Pour inciter le routeur à vous adresser votre message à un modèle en particulier, vous pouvez inclure des mots-clés comme : « Réponds simplement » ou « Sans raisonner » pour utiliser un petit modèle. « Réfléchis étape par étape » ou « Raisonne avant de répondre » pour utiliser un modèle plus puissant ou un raisonnement [52].
Réduire l'effort de réflexion
Il est recommandé d'utiliser la fonctionnalité de raisonnement uniquement lorsque la réponse à votre requête nécessite une analyse complexe, non triviale, et doit être décomposée en plusieurs étapes pour garantir la meilleure qualité possible. Vous pouvez choisir d'activer ou non le raisonnement sur les chatbots de Google, DeepSeek et Mistral.
Certains modèles, comme GPT ou Claude, permettent de paramétrer différents niveaux d'effort. Ce paramètre détermine le nombre de tokens de raisonnement et de sortie qu'il génère. Si l'on considère souvent qu'un raisonnement plus long conduit à de meilleurs résultats, ce n'est pas toujours le cas. Les performances tendent d'abord à s'améliorer à mesure que l'effort augmente, avant d'atteindre un point optimal puis, dans certains cas, de diminuer au-delà de ce seuil [53]. Il est ainsi préférable de privilégier un niveau d’effort faible à modéré.
Prompt engineering
Cette section explique l'importance du prompt/context engineering : comment fournir un contexte utile au chatbot tout en éliminant le bruit (c'est-à-dire les informations inutiles) pour qu'il accomplisse sa tâche avec précision et génère une réponse au format souhaité.
D'après les principaux fournisseurs de modèles dont OpenAI [54], la structure optimale d'un prompt repose sur plusieurs éléments clés, notamment :
- Contexte : La partie souvent la plus longue, qui peut être fortement réduite pour minimiser le nombre de tokens en entrée et clarifier la demande.
- Tâche : Généralement formulée en une phrase.
- Livrable : Court, mais essentiel pour limiter le nombre de tokens en sortie.
Optimiser le contexte pour réduire les tokens en entrée
Nous avons vu précédemment que les tokens en entrée ont également une influence sur la consommation énergétique de la requête [10]. Il est donc recommandé de limiter le contexte pour réduire l'impact environnemental, mais aussi pour améliorer la qualité de la réponse.
Optimiser le livrable pour réduire les tokens en sortie
Nous avons vu précédemment que l'impact énergétique des tokens générés en sortie est plus important que celui des tokens en entrée [7]. Il est donc généralement plus efficace, sur le plan énergétique, d'allonger le prompt envoyé pour tenter de réduire la longueur de la réponse.
Dans la plupart des cas, une réponse courte et concise suffit et évite de se perdre dans des explications inutiles.
Exemples d'instructions pour limiter la longueur de la réponse :
- Pour corriger des fautes d'orthographe dans un long texte : « Indique uniquement les corrections à apporter, sans explications et sans recopier l'intégralité du texte. »
- Pour corriger du code : « Réécris uniquement les parties à modifier sans reproduire l’intégralité du code. Ne fournit pas d’explications. »
- Pour reformuler un paragraphe dans un texte : « Réécris uniquement le paragraphe à modifier, sans recopier le reste du texte. »
À vous de déterminer ce dont vous avez besoin pour obtenir la réponse attendue, et rien de plus si ce n'est pas nécessaire.
Astuce : Certains chatbots, comme Claude, proposent de sélectionner le type de réponse. Privilégiez les options « courtes » ou « concises ».
Au contraire, l'utilisation de certains verbes d'action comme « justifie », « explique », « analyse » ou « recommande » a tendance à augmenter la quantité de texte généré [55].
Arrêter la génération
Si dès le début de la réponse du chatbot, vous constatez qu'elle ne correspond absolument pas à ce que vous attendez, interrompez-la immédiatement en cliquant sur le bouton « Stop » (généralement représenté par un carré rempli ⏹️).
Cette action simple permet de réduire le nombre de tokens générés en sortie en évitant une réponse inutile.
Modifier la demande initiale plutôt que d'envoyer un nouveau message
Lorsque la réponse générée est incomplète, interrompue ou insatisfaisante (un élément oublié dans le contexte, un détail imprécis, une partie à supprimer), préférez modifier le message initial plutôt que d'en envoyer un nouveau pour affiner votre demande.
À chaque nouveau message envoyé, tout l'historique de la conversation est réenvoyé au modèle. Cela augmente considérablement le nombre de tokens en entrée, et donc l'impact environnemental. De plus, un historique trop long introduit du bruit (informations inutiles), réduisant la qualité des réponses. Plus les tokens en entrée sont limités et pertinents, meilleure sera la réponse du chatbot.
Exemple concret : Si la réponse du chatbot ne prend pas en compte un élément important, n'envoyez pas de nouveau message en lui demandant de recommencer sa réponse en prenant en compte un paramètre supplémentaire. Privilégiez la modification du message initial pour y intégrer cette précision. Ainsi, la réponse sera regénérée avec un contexte plus complet, sans alourdir l'historique.
Cas particulier : les petites corrections Si la réponse est longue et ne nécessite qu'une petite modification :
- Ne modifiez pas le prompt initial : cela regénérerait une réponse complète et aurait un plus gros impact liée aux tokens en sortie.
- Demandez au chatbot de corriger uniquement la partie concernée sans tout réécrire. Exemple : « Corrige uniquement le troisième paragraphe, sans recopier le reste du texte. »
Cette bonne pratique demande de trouver le meilleur compromis entre :
- Regénérer une réponse en modifiant le message initial, permettant de maintenir un contexte concis, mais pouvant générer plus de tokens en sortie ;
- Ajouter un message, permettant de réduire les tokens en sortie, mais augmentant la quantité de tokens en entrée à chaque nouveau message.
Conversation engineering : créer des branches
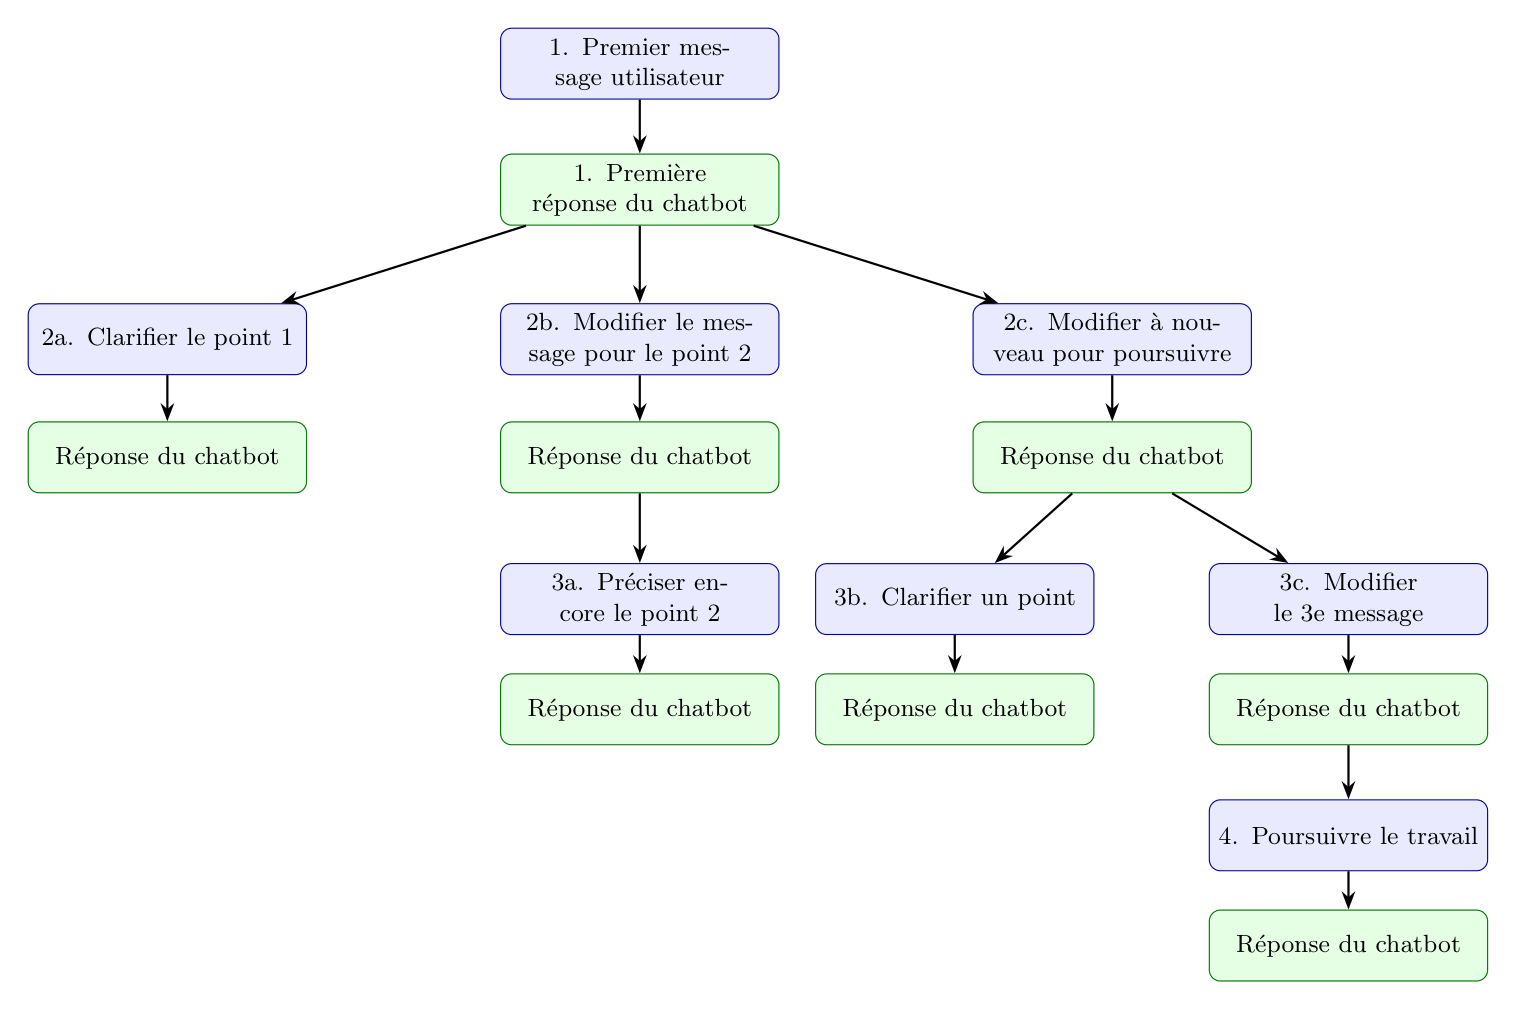
Pour maintenir un contexte minimal et utile, une technique efficace consiste à créer des branches dans une conversation. Toutes les informations échangées avec le chatbot ne sont pas nécessairement utiles pour répondre à une nouvelle demande.
Si vous demandez au chatbot d'apporter une précision sur sa réponse, mais que votre prochain message ne nécessite pas cette précision, il est préférable de modifier la question initiale plutôt que de l'ajouter à la conversation. Vous pouvez ainsi créer des branches distinctes pour chaque sujet tout en limitant le contexte au strict nécessaire.
Exemple concret :
- Vous posez une question à un chatbot sur un sujet précis.
- Il répond en abordant plusieurs points, dont certains ne sont pas clairs pour vous.
- Vous lui demandez d'approfondir le point 1.
- Pour ensuite approfondir le point 2, vous modifiez le prompt initial afin de lui demander directement des explications sur ce point, plutôt que de poser une nouvelle question dans la conversation.
- Enfin, si vous souhaitez passer à l'action à partir de la réponse initiale, demandez-lui de planifier le projet en modifiant le prompt consacré au point 2, plutôt que d'envoyer une nouvelle question.
À ce stade, votre conversation compte 3 branches :
- La première : votre question initiale sur le sujet, et un approfondissement sur le point 1 que vous n'aviez pas compris.
- La seconde : votre question initiale sur le sujet, et un approfondissement sur le point 2 que vous n'aviez pas compris.
- La troisième : votre question initiale sur le sujet, et la demande de planification.
Chaque branche traite donc d'un aspect spécifique du projet, permettant :
- De conserver une seule conversation pour l'ensemble du projet.
- D'éviter que le contexte ne soit pollué par des informations inutiles.
- D'économiser le nombre de tokens envoyés au modèle.
- De créer une méthode de prompting hiérarchisée et spécialisée.
Créer une nouvelle conversation pour chaque nouveau sujet
Nous avons constaté que chaque nouveau message envoyé entraîne le renvoi de l'intégralité de l'historique de la conversation au chatbot. Il est donc préférable de démarrer une nouvelle conversation lorsqu'on souhaite aborder un sujet sans rapport avec le précédent [56].
Deux options s'offrent à vous :
- Créer une nouvelle conversation dédiée au nouveau sujet.
- Modifier le premier message de la conversation existante pour y introduire le nouveau sujet.
En choisissant la deuxième option, vous réduisez le nombre de conversations dans votre historique, ce qui permet de maintenir un environnement propre et organisé.
Vous pouvez également réutiliser la réponse d'un chatbot en l'injectant dans une nouvelle conversation dédiée à une autre tâche, plutôt que de poursuivre dans la discussion initiale. Cette approche permet encore une fois de limiter la taille du contexte.
Supprimer les conversations inutiles
Lorsque vous envoyez un message à un chatbot, avant même l'historique de vos messages, plusieurs éléments sont inclus : le prompt du développeur, le prompt système, des informations contextuelles (pays, heure, langue, navigateur, etc.), ainsi qu'un résumé de chacune de vos conversations sauvegardées [57]. Ces résumés ajoutent du contexte pas toujours utile pour le chatbot. Supprimer vos anciennes conversations lorsqu'elles ne vous sont plus utiles.
Vider la mémoire à long terme
Lorsque vous demandez à un chatbot de retenir une information au cours d'une conversation, celle-ci sera systématiquement incluse dans les nouvelles discussions. C'est ce qu'on appelle la mémoire à long terme [58]. Pour l'optimiser, utilisez le menu dédié s'il existe, sinon créez une conversation dédiée dans laquelle vous demandez au chatbot de lister les informations qu'il a mémorisées, puis supprimez celles qui ne sont plus pertinentes.
En tant qu'entreprise développant un agent
Prioriser les algorithmes et l'IA classique à l'IA générative
Lorsque cela suffit, privilégiez l'utilisation de technologies moins complexes. Dans de nombreux cas, de simples algorithmes de décision ou des IA de prédiction ou classification classiques suffisent.
Utiliser des petits modèles spécialisés
Nous avons vu plus tôt que le nombre de paramètres activés d'un modèle a une influence importante sur l'impact environnemental du traitement d'un token.
Priorisez l'utilisation de modèles petits et spécialisés. Cela permet même parfois d'obtenir des résultats d'une meilleure précision qu'avec des grands modèles généralistes [50] [59] Des modèles déjà spécialisés sur une tâche à l'aide du fine-tuning sont mis à disposition sur Hugging Face. Privilégiez-les plutôt que de procéder à un nouveau fine-tuning.
Prompt engineering pour réduire le nombre de tokens en sortie
De la même manière que l'utilisateur peut limiter les tokens en sortie, le développeur peut préciser explicitement la forme attendue de la réponse dans le prompt système. Celui-ci est pris en compte par le modèle avant même la première requête de l'utilisateur et permet de systématiquement réduire le nombre de tokens en sortie.
Context engineering pour réduire le nombre de tokens en entrée
De nombreuses techniques existent pour limiter le contexte en ne conservant que les informations utiles.
Exemples :
- Après une conversation de 10 messages, un petit modèle peut être sollicité pour résumer les échanges. Ce résumé peut remplacer l'historique lors des prochains échanges.
- Lors d'un processus multi-étapes, les étapes peuvent être décomposées afin de ne fournir au modèle que les informations strictement nécessaires à chaque étape.
Vous pouvez concevoir de nombreuses autres méthodes pour limiter le contexte envoyé au modèle.
Fine-tuning vs Few-shots-exemples
Pour qu'un modèle produise une sortie qui correspond aux attentes, il est possible d'ajouter des exemples ou de réaliser du fine-tuning. Si l'agent ne sera pas utilisé de manière intensive*, il est recommandé d'ajouter des exemples au contexte* (one-shot ou few-shots). En revanche, pour une utilisation massive, il est préférable de réduire le nombre de tokens en entrée en passant par le fine-tuning. Il permet au modèle de comprendre le type de réponse attendu sans avoir besoin de lui fournir des exemples à chaque requête. Cependant, le fine-tuning a un coût environnemental et financier élevé.
Choisir entre le few-shots et le fine-tuning Pour déterminer le seuil à partir duquel le fine-tuning devient plus rentable, vous pouvez :
- Convertir en tokens les instructions pour la tâche et le few-shots.
- Estimer le coût par requête en fonction de ce nombre de tokens.
- Comparer le coût cumulé de toutes les requêtes avec few-shots au coût de toutes celles sans few-shots additionné au coût fixe du fine-tuning.
Lorsque le coût total des requêtes sans few-shots additionné au fine-tuning est inférieur à celui des requêtes avec few-shots, optez pour le fine-tuning.
Héberger le modèle dans un data center à faible impact énergétique et hydrique
Lorsque vous décidez d'héberger vous-même votre modèle chez un fournisseur de cloud public, vous pouvez sélectionner une région dotée d'un bon score énergétique et hydrique : facteur d'émission bas, PUE et WUE faible toute l'année.
Point de vue des émissions carbone
En vous référant aux données fournies par Ember Energy, présélectionnez un pays à faible facteur d'émission comme l'Islande, la Norvège, la Suisse ou la France.
Les principaux fournisseurs de cloud indiquent la localisation de leurs data centers par région :
- Amazon Web Services : https://aws.amazon.com/fr/about-aws/global-infrastructure/regions_az/
- Microsoft Azure : https://learn.microsoft.com/en-us/azure/reliability/regions-list?tabs=all
- Google Cloud Platform : https://datacenters.google/locations/
- Salesforce : https://help.salesforce.com/s/articleView?id=000396845&type=1
- OVH : https://www.ovhcloud.com/en/datacenter/
Une fois la région présélectionnée, prenez en compte le PUE du fournisseur. Vous pouvez retrouver ces valeurs par région pour les principaux fournisseurs de cloud :
- Amazon Web Services : https://sustainability.aboutamazon.com/products-services/aws-cloud
- Microsoft Azure : https://datacenters.microsoft.com/sustainability/efficiency/
- Google Cloud Platform : https://datacenters.google/efficiency/
- OVH : https://www.ovhcloud.com/sites/default/files/external_files/kpis_fy25.pdf
Point de vue de la consommation d'eau
Vérifiez que la région présélectionnée n'est pas à risque de sécheresse. Pour évaluer les risques liés à la disponibilité de l'eau, le World Resources Institute (WRI) propose une carte des régions à fort risque de sécheresse : https://www.wri.org/aqueduct/tools.
Enfin, regardez le WUE. Lorsque cet indicateur est manquant, considérez le WUE de la région d'un autre fournisseur :
- Amazon Web Services : https://sustainability.aboutamazon.com/products-services/aws-cloud/ ;
- Microsoft Azure : https://datacenters.microsoft.com/sustainability/efficiency/ ;
- Google Cloud Platform : lien https://services.google.com/fh/files/misc/measuring_the_environmental_impact_of_delivering_ai_at_google_scale.pdf ;
- OVH : https://www.ovhcloud.com/sites/default/files/external_files/kpis_fy25.pdf.
Moteur d'inférence
Certains fournisseurs optimisent leurs modèles pour des moteurs d'inférence spécifiques [28]. Le moteur adéquat peut être indiqué dans la carte de présentation du modèle.
Utiliser le cache
La fonctionnalité de cache permet de stocker et de réutiliser les calculs d'attention ainsi que les tokens d'un prompt déjà traité, évitant ainsi de tout recalculer à chaque requête.
Cas d'usage optimisés avec le cache :
- Répétition d'un contexte volumineux : par exemple lorsque vous envoyez fréquemment la même documentation dans le contexte, ou l'historique complet d'une conversation (cas d'un chatbot).
- Agents autonomes : les agents effectuant des appels successifs en s'appuyant sur le même prompt système (instructions de base, outils disponibles, exemples de guidage) et un état partagé.
- Assistants de code : analyse d'un dépôt de code volumineux et identique à chaque message.
Pour qu'un cache soit efficace, les requêtes doivent être peu espacées dans le temps et le préfixe du prompt (la partie à mettre en cache) doit être strictement identique d'une requête à l'autre. Le moindre espace ou caractère modifié au début du texte invalidera tout ou partie du cache existant.
Traitement par lots (Batch processing)
Le batch processing consiste à envoyer un grand nombre de requêtes à traiter simultanément. Cette méthode optimise l'inférence du modèle et permet de réduire significativement le coût énergétique et financier [60].
Les fournisseurs de modèles via API proposent généralement le batch processing à moitié prix par rapport au traitement classique. Bien qu'il n'existe pas de données précises dans la littérature quantifiant cette réduction, on peut supposer que la variation du prix est corrélée à celle de l'impact énergétique.
Envoyez périodiquement toutes les requêtes en batch si vous n'avez pas besoin des réponses du modèle en temps réel, que le volume de requêtes est important et qu'elles sont indépendantes les unes des autres.
Modèles récents
Restez informés sur les nouveaux modèles car certains peuvent offrir des performances équivalentes à celles de votre modèle actuel tout en ayant un impact plus faible, grâce à une optimisation ou une innovation.
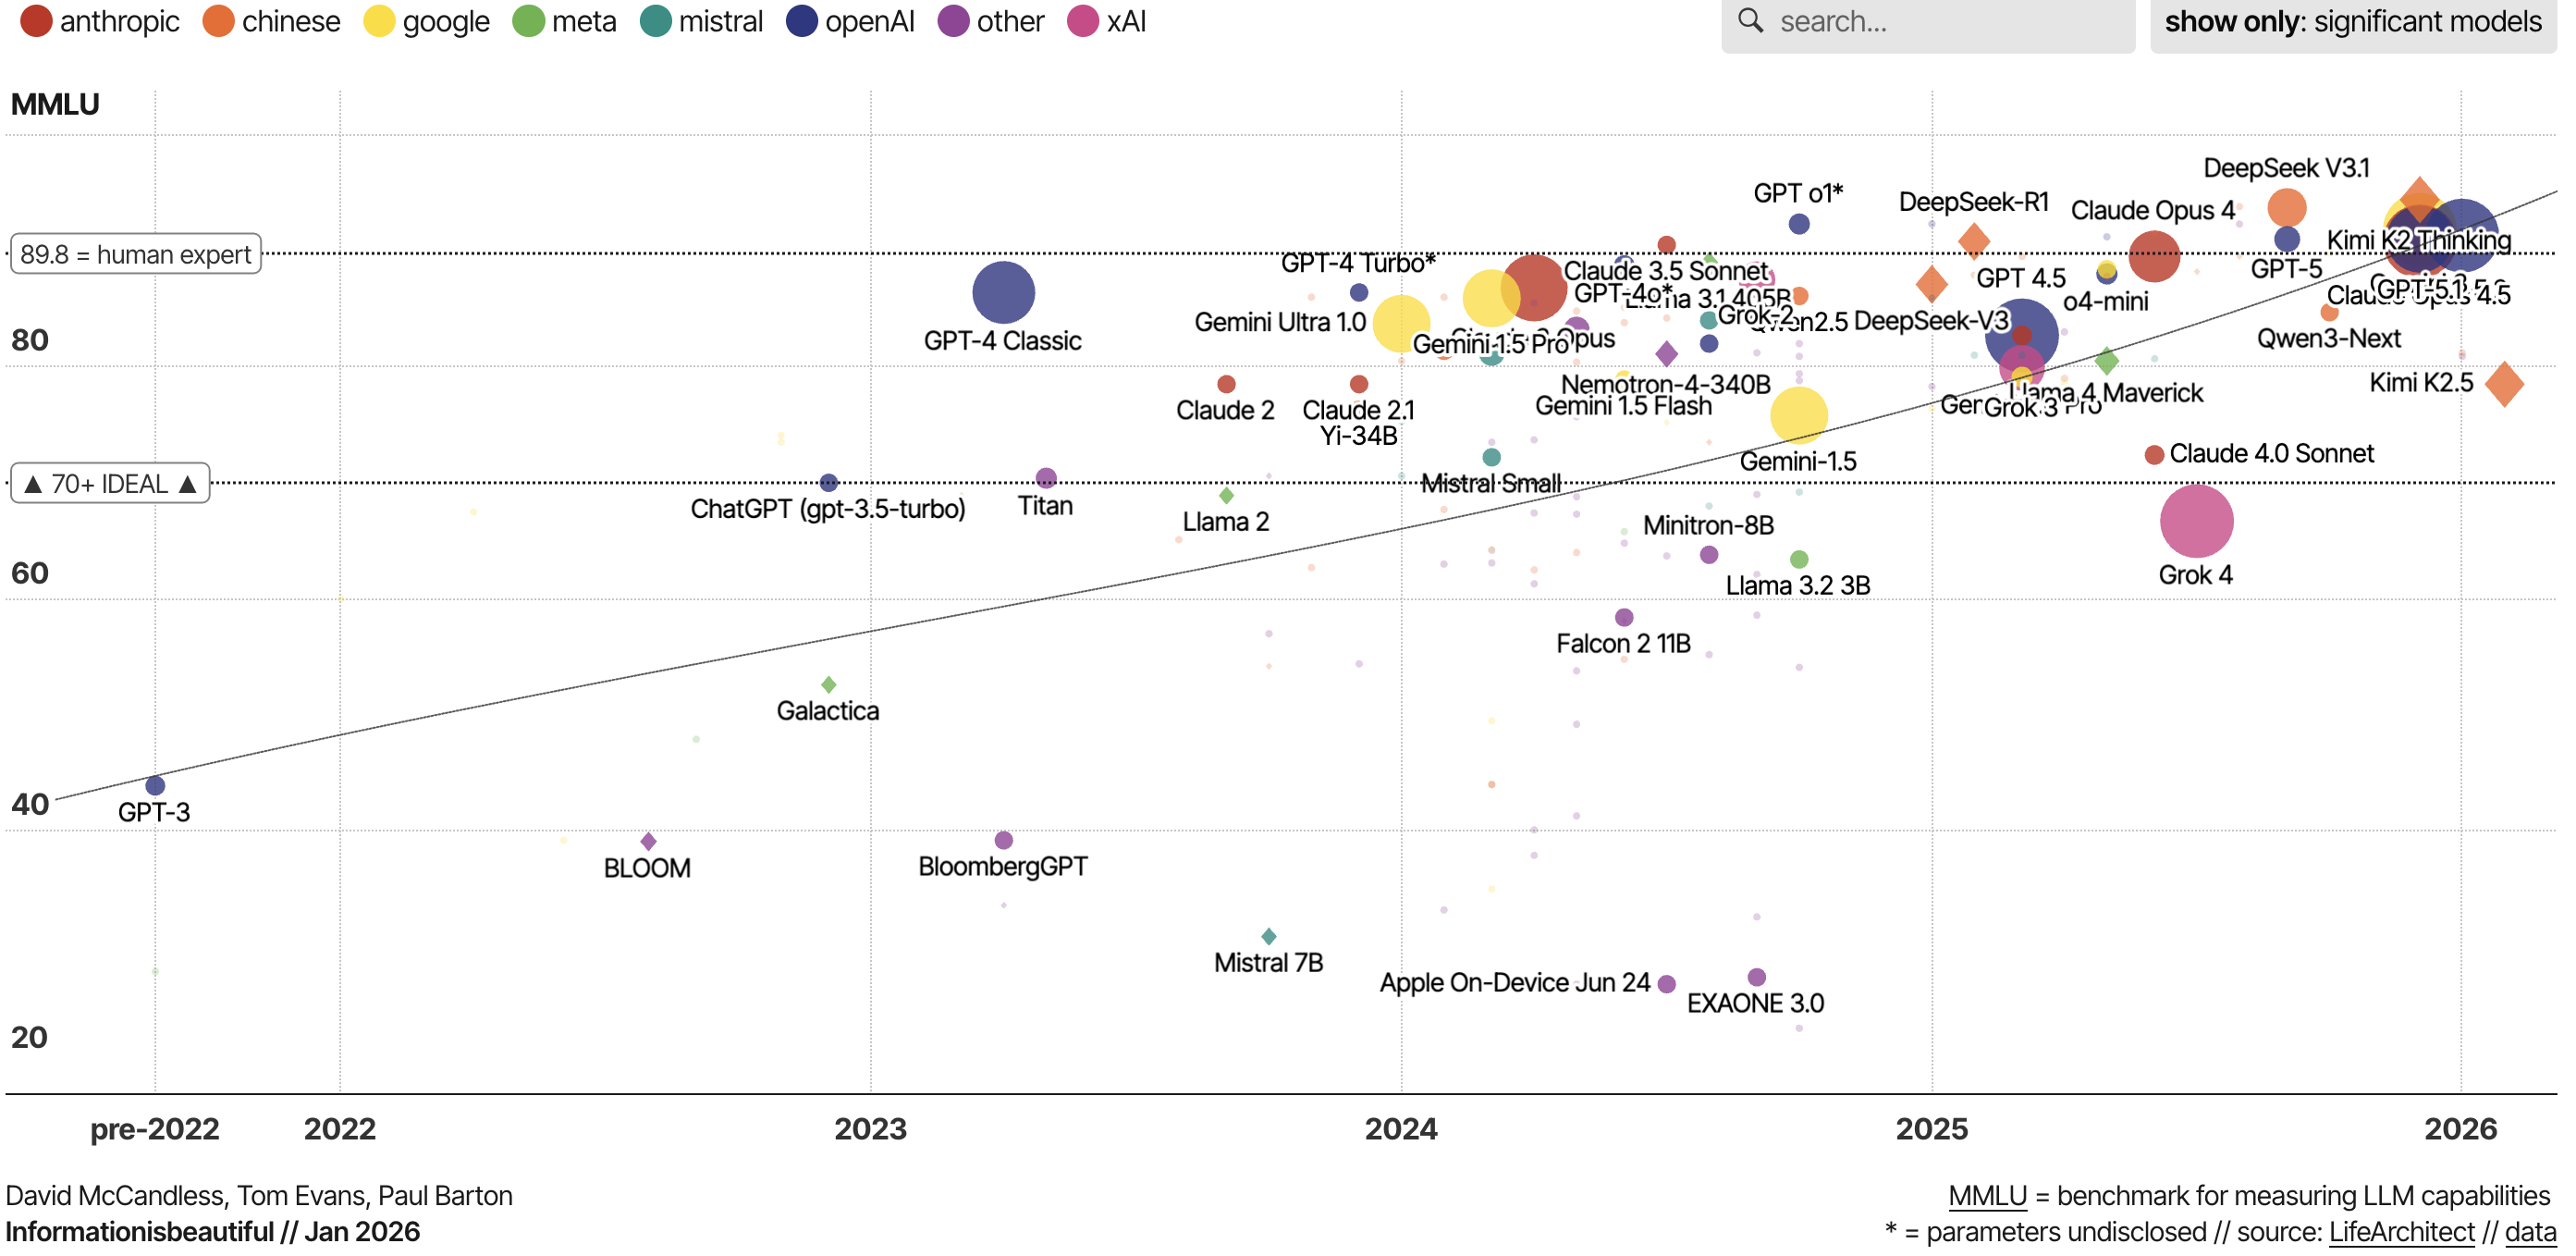
Panorama mondial des LLM et de leurs performances [61]
Pour la génération d'images par exemple, une étude suggère que les choix du type de modèle devraient tenir compte de la longueur prévue de la sortie : les modèles autorégressifs (les plus utilisés) restent préférables pour les réponses courtes (moins de 1024 tokens), tandis que les modèles de diffusion offrent des avantages indéniables pour les tâches de génération plus longues [62].
Attention, changer de modèle peut induire une nouvelle phase de développement (évaluation, fine-tuning) impliquant un impact environnemental significatif. De plus, optimiser une technologie a plutôt tendance à augmenter son impact au global car elle devient peu coûteuse et est donc beaucoup plus utilisée. C'est l'effet rebond [63].
« La quantization » : réduire la précision des calculs réduit les besoins en énergie
« Quantizer » un modèle consiste à réduire la précision de ses calculs. On passe de nombres flottants à des nombres entiers. En réduisant la précision des calculs, on peut, dans certaines conditions, réduire la quantité d'énergie consommée par le modèle [64] [60]. Bien sûr, cette réduction de décimales entraîne une perte de précision dans les calculs. Mais aujourd'hui, il est possible d'utiliser des modèles « quantizés » tout en conservant de très bonnes performances.
La distillation : quand l'élève dépasse le maître
Une technique permettant de réduire la taille des modèles et, par conséquent, leur impact à l'exécution, est la distillation des connaissances. C'est cette technique qui a été utilisée pour créer DeepSeek avec une fraction du coût énergétique de ChatGPT [65]. Elle consiste à utiliser un modèle professeur, de très grande taille, pour générer des données qui serviront ensuite à affiner l'entraînement d'un autre modèle, appelé modèle élève, beaucoup plus petit. Le modèle élève peut ainsi acquérir des connaissances similaires à celles de son professeur, tout en nécessitant beaucoup moins de ressources pour son exécution [66].
Les modèles élagués (Pruning)
L'élagage (pruning) consiste à supprimer des paramètres du modèle. Cette technique permet de réduire fortement la taille, et donc le coût d'exécution, tout en conservant de bonnes performances [67].
Conclusion
Synthèse
Avant de réduire son impact environnemental lié à l'IA générative, il faut comprendre les facteurs qui l'influencent. On peut les regrouper en 3 catégories : le modèle, son hébergement, et les tokens.
Des outils existent pour mesurer celui des modèles ouverts avec précision et certitude. Les modèles propriétaires les plus puissants comme ceux d'OpenAI, Google ou Anthropic sont des boîtes noires et ne permettent pas d'établir une mesure certaine. Des organismes indépendants développent des méthodes d'estimation basées sur de nombreuses hypothèses non vérifiables, mais sur lesquelles on peut s'appuyer pour obtenir des ordres de grandeur.
La calculatrice que j'ai développée en parallèle de cet article permet à l'utilisateur final d'un chatbot de quantifier la réduction de son impact en mettant en place des bonnes pratiques : Calculatrice Impact Environnemental de ma conversation avec l'IA
À son niveau, les trois principaux leviers qu'il peut actionner instantanément sont :
- la priorisation d'une recherche web classique, en désactivant les recherches par IA automatiques.
- le choix d'un modèle de petite taille avec un effort faible, adapté à la tâche à réaliser
- la maîtrise de la quantité de tokens traités en entrée et générés en sortie.
En tant que développeur, l'amplitude d'action est plus large et touche des concepts invisibles pour l'utilisateur final.
À tous les niveaux, il est possible de drastiquement réduire l'impact environnemental lié à son utilisation de l'IA, tout en augmentant la qualité des réponses produites.
Ouverture
Cet article est une synthèse des connaissances que j’ai accumulées au cours d’un an et demi de recherche, ainsi que de ma veille informationnelle continue sur le sujet. Je tiens tout particulièrement à remercier Boris RUF, qui a partagé avec moi ses connaissances et ses compétences tout au long de cette période, alors que j'exerçais en tant que Data Scientist chez AXA Group Operations. Je souhaite également remercier Céline LESCOP, qui m’a donné l’opportunité et l’envie d’approfondir le sujet du numérique écoresponsable en me permettant de participer au programme Digital Sustainability.
Si vous souhaitez approfondir le sujet, former vos équipes métier et IT aux bonnes pratiques, réaliser un bilan environnemental de vos outils existants ou concevoir de nouveaux outils, n’hésitez pas à me contacter. Je serai ravi d’intervenir au sein de votre organisation pour vous accompagner dans cette démarche.
Enfin, je reste ouvert à vos retours, critiques constructives et suggestions d’amélioration, tant sur le contenu de cet article que sur l’outil associé.
Références
- Marianne Enault (2025). Intelligence artificielle : ce qu’il faut savoir sur son impact sur la planète. TF1 Info. Mis à jour le 10 février 2025. https://www.tf1info.fr/environnement-ecologie/sommet-intelligence-artificielle-paris-ce-qu-il-faut-savoir-sur-son-impact-sur-la-planete-2349018.html ↩
- IPCC (2021). Summary for Policymakers. Climate Change 2021: The Physical Science Basis, GIEC. https://report.ipcc.ch/ar6syr/headline.html ↩
- Leo XIV (2026). Magnifica Humanitas: Encyclical Letter of His Holiness Pope Leo XIV on Safeguarding the Human Person in the Time of Artificial Intelligence. The Holy See. https://www.vatican.va/content/leo-xiv/en/encyclicals/documents/20260515-magnifica-humanitas.html ↩
- International Energy Agency (2025). Energy and AI. International Energy Agency. https://iea.blob.core.windows.net/assets/de9dea13-b07d-42c5-a398-d1b3ae17d866/EnergyandAI.pdf ↩
- Miriam Aczel, Sanaz Chamanara, Mir Matin, Aria Farsi, Tshilidzi Marwala, Kaveh Madani (2026). Environmental Cost of AI's Energy Use: Carbon, Water and Land Footprints. United Nations University Institute for Water, Environment and Health (UNU-INWEH). https://doi.org/10.53328/INR26RMA002 ↩ ↩
- OpenAI (2026). Tokenizer. https://platform.openai.com/tokenizer ↩
- Francisco Caravaca (2026). Measuring Energy Consumption of LLMs Inferences. ACM SIGMETRICS Performance Evaluation Review. https://doi.org/10.1145/3788882.3788890 ↩ ↩
- Tina Vartziotis, Rodopi Kosteli, Elli Vartziotis, George Dasoulas, Michael Keckeisen, Konstantinos Skianis, Sotirios Kotsopoulos, Francesca Dominici (2026). From Tokens to Watt-hours: Analytical Energy Estimation for LLM Inference on Modern GPUs. https://arxiv.org/abs/2607.26571 ↩ ↩
- Lola Solovyeva, Fernando Castor (2026). Towards Green AI: Decoding the Energy of LLM Inference in Software Development. ArXiv.org. ↩
- Boris Ruf, Marcin Detyniecki (2026). The Cost of Context: Profiling the Energy Footprint of Input Tokens in Large Language Models. ACM SIGENERGY Energy Informatics Review. https://hotcarbon.org/assets/2026/paper-17.pdf ↩ ↩
- Maximilian Dauner, Gudrun Socher (2025). Energy costs of communicating with AI. Frontiers in Communication. https://www.frontiersin.org/journals/communication/articles/10.3389/fcomm.2025.1572947 ↩
- Jon Saad-Falcon, Avanika Narayan, Hakki Orhun Akengin, J. Wes Griffin, Herumb Shandilya, Adrian Gamarra Lafuente, Medhya Goel, Rebecca Joseph, Shlok Natarajan, Etash Kumar Guha, Shang Zhu, Ben Athiwaratkun, John Hennessy, Azalia Mirhoseini, Christopher Ré (2026). Intelligence per Watt: Measuring Intelligence Efficiency of Local AI. https://arxiv.org/abs/2511.07885 ↩
- International Energy Agency (2025). Emissions Factors 2025. Licence: Terms of Use for Non-CC Material. https://www.iea.org/data-and-statistics/data-product/emissions-factors-2025 ↩
- ADEME (2013). Base Empreinte® — Découverte. https://base-empreinte.ademe.fr/aide/decouverte ↩
- Ember (2026). Yearly Electricity Data. https://ember-energy.org/data/yearly-electricity-data/ ↩
- Willie Jones (2008). How Much Water Does It Take to Make Electricity? IEEE Spectrum. https://spectrum.ieee.org/how-much-water-does-it-take-to-make-electricity ↩
- Jessica Le Goff (2023). Comment réduire la consommation d’eau des systèmes de refroidissement des data centers. https://www.apl-datacenter.com/fr/ressources/avis-experts/reduire-consommation-eau-des-systemes-de-refroidissement-data-centers/ ↩
- Michael Patterson, Dan Azevedo, Christian Belady, Jack Pouchet (2011). WP\#35 - Water Usage Effectiveness (WUE): A Green Grid Data Center Sustainability Metric. https://archive.thegreengrid.org/en/resources/library-and-tools/238-WP\#35---Water-Usage-Effectiveness-(WUE):-A-Green-Grid-Data-Center-Sustainability-Metric- ↩
- Christopher Malone, Christian L. Belady (2006). Metrics to Characterize Data Center & IT Equipment Energy Use. Proceedings of the Digital Power Forum. https://www.researchgate.net/publication/337801067_Metrics_to_Characterize_Data_Center_IT_Equipment_Energy_Use_Proceedings_of_Digital_Power_Forum_Richardson_TX ↩
- Petroc Taylor (2026). Data Center Average Annual Power Usage Effectiveness (PUE) Worldwide from 2007 to 2025. https://www.statista.com/statistics/1229367/data-center-average-annual-pue-worldwide/ ↩
- Google Data Centers (2026). Power usage effectiveness. https://datacenters.google/efficiency/ ↩
- Mistral AI (2025). Our contribution to a global environmental standard for AI. https://mistral.ai/news/our-contribution-to-a-global-environmental-standard-for-ai/ ↩ ↩
- Johannes Zschache, Tilman Hartwig (2026). Comparing energy consumption and accuracy in text classification inference. Scientific Reports. https://doi.org/10.1038/s41598-026-45023-0 ↩ ↩
- Bojie Li (2026). Incompressible Knowledge Probes: Estimating Black-Box LLM Parameter Counts via Factual Capacity. https://arxiv.org/abs/2604.24827 ↩ ↩
- Mingdeng Du (2026). Tiered Super-Moore's Law: Price Evolution, Production Frontiers, and Market Competition in Large Language Model Inference Services. https://arxiv.org/abs/2603.28576 ↩
- Siyuan Mu, Sen Lin (2026). A Comprehensive Survey of Mixture-of-Experts: Algorithms, Theory, and Applications. https://arxiv.org/abs/2503.07137 ↩
- Chenxu Niu, Wei Zhang, Yongjian Zhao, Yong Chen (2025). Energy Efficient or Exhaustive? Benchmarking Power Consumption of LLM Inference Engines. ACM SIGEnergy Energy Informatics Review. https://doi.org/10.1145/3757892.3757900 ↩
- NVIDIA Corporation (2026). LLM Inference Quick Start Recipes. https://docs.nvidia.com/llm-inference-quick-start-recipes/overview ↩ ↩
- Jae-Won Chung, Jeff J. Ma, Ruofan Wu, Jiachen Liu, Oh Jun Kweon, Yuxuan Xia, Zhiyu Wu, Mosharaf Chowdhury (2025). The ML.ENERGY Benchmark: Toward Automated Inference Energy Measurement and Optimization. https://arxiv.org/abs/2505.06371 ↩ ↩
- Jie You, Jae-Won Chung, Mosharaf Chowdhury (2023). Zeus: Understanding and Optimizing GPU Energy Consumption of DNN Training. USENIX NSDI, University of Michigan. ↩ ↩
- OpenAI Academy (2026). Environmental Impact of AI. Consulté le 16 août 2026. https://academy.openai.com/public/clubs/higher-education-05x4z/resources/environmental-impact-of-ai ↩
- Cooper Elsworth, Keguo Huang, David Patterson, Ian Schneider, Robert Sedivy, Savannah Goodman, Ben Townsend, Parthasarathy Ranganathan, Jeff Dean, Amin Vahdat, Ben Gomes, James Manyika (2025). Measuring the environmental impact of delivering AI at Google Scale. https://arxiv.org/abs/2508.15734 ↩
- Sam Altman (2025). The Gentle Singularity. https://blog.samaltman.com/the-gentle-singularity ↩
- Sasha Luccioni, Yacine Jernite, Emma Strubell (2024). Power Hungry Processing: Watts Driving the Cost of AI Deployment? The 2024 ACM Conference on Fairness Accountability and Transparency, ACM. http://dx.doi.org/10.1145/3630106.3658542 ↩
- Epoch AI (2026). How Much Energy Does ChatGPT Use? Epoch AI. Consulté le 16 août 2026. https://epoch.ai/gradient-updates/how-much-energy-does-chatgpt-use ↩
- Nidhal Jegham, Marwan Abdelatti, Chan Young Koh, Lassad Elmoubarki, Abdeltawab Hendawi (2025). How Hungry is AI? Benchmarking Energy, Water, and Carbon Footprint of LLM Inference. https://arxiv.org/abs/2505.09598 ↩
- Samuel Rincé, Adrien Banse (2025). EcoLogits: Evaluating the Environmental Impacts of Generative AI. Journal of Open Source Software. https://joss.theoj.org/papers/10.21105/joss.07471.pdf ↩
- SNCFdevelopers (2026). Impact'IA: LLM Environmental Footprint Calculator. Calculatrice d'impact environnemental des modèles de langage et guide méthodologique. https://github.com/SNCFdevelopers/ImpactIA ↩ ↩
- Hugging Face (2026). LLM Perf Leaderboard. https://huggingface.co/spaces/optimum/llm-perf-leaderboard ↩ ↩
- Alex de Vries (2023). The growing energy footprint of artificial intelligence. Joule. https://www.sciencedirect.com/science/article/pii/S2542435123003653 ↩
- Tianqi Xiao, Francesco Fuso Nerini, H. Damon Matthews, Massimo Tavoni, Fengqi You (2025). Environmental impact and net-zero pathways for sustainable artificial intelligence servers in the USA. Nature Sustainability. https://doi.org/10.1038/s41893-025-01681-y ↩
- Jeffrey Dastin, Stephen Nellis (2023). Focus: For tech giants, AI like Bing and Bard poses billion-dollar search problem. Reuters. ↩
- Boris Ruf, Marcin Detyniecki (2023). Open and Linked Data Model for Carbon Footprint Scenarios. https://arxiv.org/abs/2310.01278 ↩
- Benoît Courty, Victor Schmidt, Goyal-Kamal, inimaz, MarionCoutarel, Luis Blanche, Boris Feld, Amine Saboni, Jérémy Lecourt, LiamConnell, David Berenstein, Patrick LLORET, SabAmine, supatomic, cianc, Mathilde Léval, Alexis Cruveiller, ouminasara, Franklin Zhao, rosekelly6400 (2026). mlco2/codecarbon: v3.3.0. Zenodo. Version 3.3.0. https://doi.org/10.5281/zenodo.21791294 ↩
- Samuel Rincé, Adrien Banse, Valentin Defour, Caroline Jean-Pierre (2025). EcoLogits Calculator. https://calculator.ecologits.ai/ ↩
- Samuel Rincé (2022). Awesome Green AI. Dépôt GitHub, consulté le 9 octobre 2026. https://github.com/samuelrince/awesome-green-ai ↩
- Urs Hölzle (2009). Powering a Google search. https://googleblog.blogspot.com/2009/01/powering-google-search.html ↩
- Wim Vanderbauwhede (2025). Estimating the Increase in Emissions caused by AI-augmented Search. https://arxiv.org/abs/2407.16894 ↩
- Lingjiao Chen, Matei Zaharia, James Zou (2023). FrugalGPT: How to Use Large Language Models While Reducing Cost and Improving Performance. https://arxiv.org/abs/2305.05176 ↩
- Jinghan Cao, Yu Ma, Xinjin Li, Qingyang Ren, Xiangyun Chen (2026). Task-Specific Efficiency Analysis: When Small Language Models Outperform Large Language Models. https://arxiv.org/abs/2603.21389 ↩ ↩
- OpenAI (2026). Improving GPT-5.6 Sol in ChatGPT---and expanding access to GPT-5.6 Luna for free users. https://openai.com/index/improving-gpt-5-6-sol-in-chatgpt/ ↩
- Anthropic (2025). Best practices for prompt engineering for 2026. https://claude.com/blog/best-practices-for-prompt-engineering ↩
- Yuyang Wu, Yifei Wang, Ziyu Ye, Tianqi Du, Stefanie Jegelka, Yisen Wang (2025). When More is Less: Understanding Chain-of-Thought Length in LLMs. https://arxiv.org/abs/2502.07266 ↩
- OpenAI (2026). Prompt engineering. https://developers.openai.com/api/docs/guides/prompt-engineering ↩
- Marta Adamska, Daria Smirnova, Hamid Nasiri, Zhengxin Yu, Peter Garraghan (2026). Green Prompting: Characterizing Prompt-driven Energy Costs of LLM Inference. https://arxiv.org/abs/2503.10666 ↩
- Boris Ruf, Marcin Detyniecki (2025). Mitigating the Carbon Footprint of Chatbots as Consumers. Trends in Sustainable Computing and Machine Intelligence, Springer Nature Singapore. http://dx.doi.org/10.1007/978-981-96-1452-3_2 ↩
- Shardul Mane (2026). What Is Context Engineering? https://supermemory.ai/blog/what-is-context-engineering-complete-guide/ ↩
- OpenAI (2024). Mémoire et nouveaux contrôles pour ChatGPT. https://openai.com/fr-FR/index/memory-and-new-controls-for-chatgpt/ ↩
- Beibin Li, Yi Zhang, Sébastien Bubeck, Jeevan Pathuri, Ishai Menache (2024). Small Language Models for Application Interactions: A Case Study. https://arxiv.org/abs/2405.20347 ↩
- Soham Poddar, Paramita Koley, Janardan Misra, Sanjay Podder, Niloy Ganguly, Saptarshi Ghosh (2025). Towards Sustainable NLP: Insights from Benchmarking Inference Energy in Large Language Models. https://arxiv.org/abs/2502.05610 ↩ ↩
- M David, E Tom, B Paul (2025). Major large language models (LLMs): ranked by capabilities, sized by billion parameters used for training. https://informationisbeautiful.net/visualizations/the-rise-of-generative-ai-large-language-models-llms-like-chatgpt ↩
- Boris Ruf, Marcin Detyniecki (2026). Energy Consumption Analysis of Discrete Diffusion and Autoregressive Language Models. Proceedings of the 2nd International Workshop on Systems and Methods for Sustainable Large-Scale AI (GreenSys), Association for Computing Machinery. https://doi.org/10.1145/3802973.3804458 ↩
- William Stanley Jevons (1865). The Coal Question: An Inquiry Concerning the Progress of the Nation, and the Probable Exhaustion of Our Coal-Mines. Macmillan and Co. ↩
- Julien Delavande, Regis Pierrard, Sasha Luccioni (2026). Understanding Efficiency: Quantization, Batching, and Serving Strategies in LLM Energy Use. https://arxiv.org/abs/2601.22362 ↩
- Scott Young (2025). DeepSeek, ChatGPT, and the global fight for technological supremacy. https://hls.harvard.edu/today/deepseek-chatgpt-and-the-global-fight-for-technological-supremacy/ ↩
- Xiaoqi Jiao, Yichun Yin, Lifeng Shang, Xin Jiang, Xiao Chen, Linlin Li, Fang Wang, Qun Liu (2020). TinyBERT: Distilling BERT for Natural Language Understanding. Findings of the Association for Computational Linguistics: EMNLP 2020, Association for Computational Linguistics. https://aclanthology.org/2020.findings-emnlp.372/ ↩
- Mengzhou Xia, Tianyu Gao, Zhiyuan Zeng, Danqi Chen (2024). Sheared LLaMA: Accelerating Language Model Pre-training via Structured Pruning. International Conference on Learning Representations. https://proceedings.iclr.cc/paper_files/paper/2024/file/160adf2dc118a920e7858484b92a37d8-Paper-Conference.pdf ↩